Diseño y construyo sistemas de agentes de IA que hacen trabajo real y verificable. Cofundé PDsites, un estudio que crea webs y automatizaciones con IA para negocios locales, y diseñé el sistema de agentes que produce su trabajo. Por mi cuenta construyo AStar, un entrenador de exámenes con IA para Business y Economics de Edexcel A-level, y el entorno en el que trabajo: un equipo de agentes que planifica, construye y revisa su propio trabajo. A su alrededor hay un sistema de lectura que convierte lo que leo en conocimiento para mis proyectos, un motor de contenido para imágenes y vídeo generados con IA y un sistema de predicción de fútbol. Mi enfoque es que la IA sea fiable: planes escritos, rutas definidas, revisión independiente y comprobaciones automáticas. Cada cifra de esta página está contada de mis propios archivos, con su tamaño de muestra y la fecha en que se midió.
Competencias, con su prueba
Arquitectura multiagente
Roles de orquestador, ejecutor y revisor, y enrutamiento en forma de grafo. 40 agentes entre el estudio y mi entorno propio, más 15 habilidades de IA dentro de AStar.
Calidad y verificación
Comprobaciones automáticas con fallos sembrados a propósito, revisores de solo lectura y reglas que escalan a bloqueos cuando un error se repite. El examinador de AStar queda a 1 punto o menos de la nota real de Pearson en el 88 % de 33 exámenes de compañeros (82 % con su paso de calibración).
Producto
Planes por etapas con criterios de cierre escritos, un lanzamiento mínimo definido y una medición honesta, incluidos los números que no llegan al objetivo.
Datos y recuperación
Recuperación vectorial sobre 2.470 preguntas reales de examen, DuckDB, modelos de Poisson calibrados y backtests con hipótesis registradas de antemano.
Imagen y vídeo generativos
Personajes que conservan cara y cuerpo, recetas reproducibles, montaje determinista y un editor de nodos propio.
Seguridad
Un filtro que impide que cualquier clave secreta llegue al disco, deshacer para las ejecuciones desatendidas y una revisión de seguridad escrita de AStar cerrada sin puntos abiertos.
Empresa
PDsites
Mayo 2026 – actualidad
Cofundador
Estudio que crea webs y automatizaciones con IA para negocios locales. Soy responsable de la arquitectura del sistema de producción, las automatizaciones y la venta.
El estudio empezó con un flujo lineal: un orquestador lanzaba en fila investigación, fotografía, dirección de diseño, textos, construcción, ficha comercial y ficha de Google, y un revisor cerraba cada ronda. 26 agentes compartían un único manual que llegó a 6.617 líneas. Todas las peticiones recorrían el flujo completo, también las pequeñas: cambiar un horario requirió 7 agentes, 55 minutos y 56 escrituras de archivo.
Solución
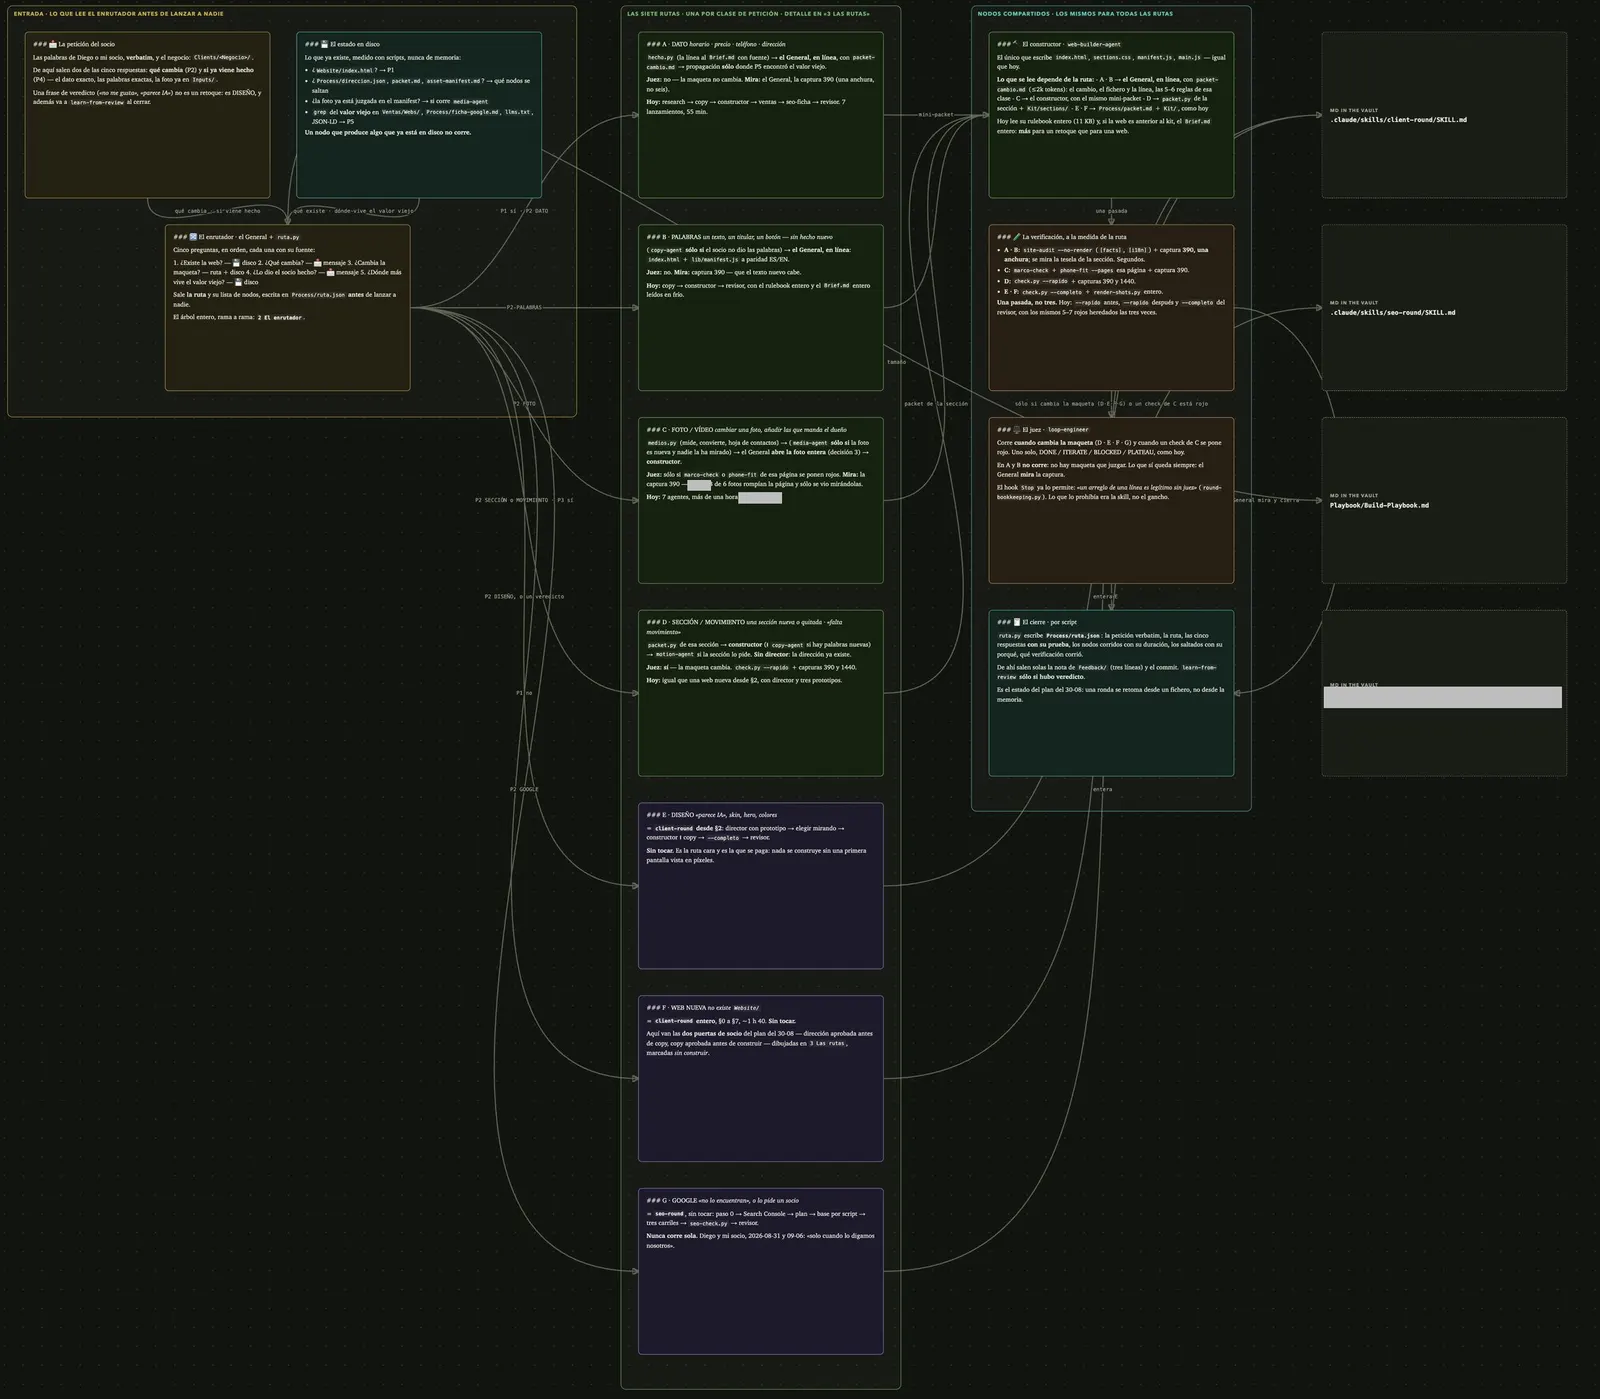
Rediseñé el sistema como un grafo. Un script enrutador hace cinco preguntas antes de lanzar ningún agente y asigna una de siete rutas; cada ruta ejecuta solo los nodos necesarios, en paralelo cuando puede, y registra qué omitió y por qué. Además especialicé a los agentes: 18 agentes, un manual por agente, un máximo de 3 skills por agente y paquetes de contexto limitados en tamaño, para que cada uno reciba solo lo que su tarea necesita.
Resultados
Cambios pequeños en 8–9 minutos, antes 55
De 7 a 3 agentes en el mismo encargo
De 26 a 18 agentes, cada uno con un rol único
Webs nuevas: 3 prototipos de primera pantalla, elección humana y 15 comprobaciones automáticas
En cifras
La web del propio estudio, pdsites.es, está publicada en 5 idiomas (español, inglés, neerlandés, noruego y ruso) en 12 páginas, y no carga ningún script, fuente ni rastreador de terceros.
36 proyectos web construidos con un único kit compartido: 14 estilos visuales y 32 plantillas de sección sobre una base común de 2.217 líneas.
15 comprobaciones automáticas se ejecutan con un solo comando antes de que nadie vea una web, tomadas de 31 scripts de control que tienen su propia autoprueba. Ejecutar toda la batería sobre una única vista previa la redujo de 380 segundos a menos de 90.
El manual del estudio se comprimió de 20.079 líneas a unas 1.200 sin perder ninguna regla. El archivo de estándares pasó de 6.617 líneas a 403, y 66 de sus reglas llevan un verificador automático.
Hay 249 correcciones fechadas de los socios registradas en 46 archivos, y cada regla enlaza con la corrección que la originó.
Tres automatizaciones están activas en el servidor n8n propio del estudio para un restaurante: reservas (129 nodos), lista de espera de mesas libres (61) y solicitud de reseña al día siguiente (13). En la última ejecución, el 4 de septiembre de 2026, su verificador automático pasó 453, 148 y 56 comprobaciones con 0 fallos, y el traslado de sus datos a una base de datos propia se verificó campo a campo: 908 comparaciones, 0 fallos.
Un motor de captación de 13 scripts, cada uno con autoprueba sin conexión, encontró 10.459 negocios en Google Maps en la provincia de Alicante, conservó 9.701 tras descartar organismos públicos, cadenas y duplicados, puntuó cada uno y generó una lista de llamadas de 5.142 y 362 negocios aptos para correo. El envío está sujeto a la aprobación de un socio.
Una base legal en disco: 14 leyes y 2.103 artículos de los datos abiertos del boletín oficial, con la regla de que no se afirma nada sobre una ley sin un artículo abierto y citado.
Un panel de equipo de unas 17.200 líneas de Python en el servidor propio del estudio, donde Claude ejecuta tareas reales con seguimiento de coste y un botón de parada.
Cómo funciona el grafo
Cinco preguntas
¿Existe ya la web? ¿Qué cambia (dato, texto, foto, sección, diseño, Google)? ¿Cambia la maqueta? ¿El contenido ya viene dado? ¿Dónde más aparece el valor antiguo?
Rutas cortas
Para datos, textos, fotos y secciones: sin investigación, sin director de diseño y con revisión solo cuando cambia la maqueta o falla una comprobación.
Ronda completa
Para diseño y webs nuevas: investigación, medios y dirección en paralelo, tres prototipos de primera pantalla, construcción y textos en paralelo, 15 comprobaciones automáticas y una revisión final.
Especialización por entregable
El SEO se dividió en tres agentes (la página, las respuestas de buscadores con IA y la ficha de Google) en lugar de uno por etapa.
Figura: el grafo de enrutamiento (canvas de Obsidian): la petición y el estado en disco entran en un enrutador, siete rutas y los nodos compartidos por todas. Se han tapado el nombre de una localidad y el de una carpeta de cliente.
Un sistema que se mejora solo
Cada revisión alimenta el sistema sin que nadie repita una instrucción. Las palabras literales del socio se guardan primero, en su idioma, como evidencia. Se traducen a un elemento concreto; si un comentario como «parece hecho con IA» sigue siendo ambiguo, el sistema pregunta en lugar de adivinar. Después comprueba si ya se había dicho. Si es nuevo, se escribe una regla corta con autor y fecha, solo en los manuales de los agentes a los que aplica. Si es una repetición, no se escribe otra regla: la existente sube de nivel, de documento a lista de control, de lista a script y de script a bloqueo. Desde agosto, toda regla repetida tiene que nombrar el script que la hace cumplir, y cada manual tiene un tope de 60 reglas, así que una regla nueva desplaza a una antigua en lugar de acumularse.
Control de calidad
15 comprobaciones automáticas se ejecutan antes de que nadie vea una web. Una mide en píxeles la primera pantalla del móvil y está validada en las dos direcciones: aprueba las webs que los socios aprobaron y suspende las que rechazaron. Cada comprobación lleva anotada la queja que la originó.
Automatizaciones
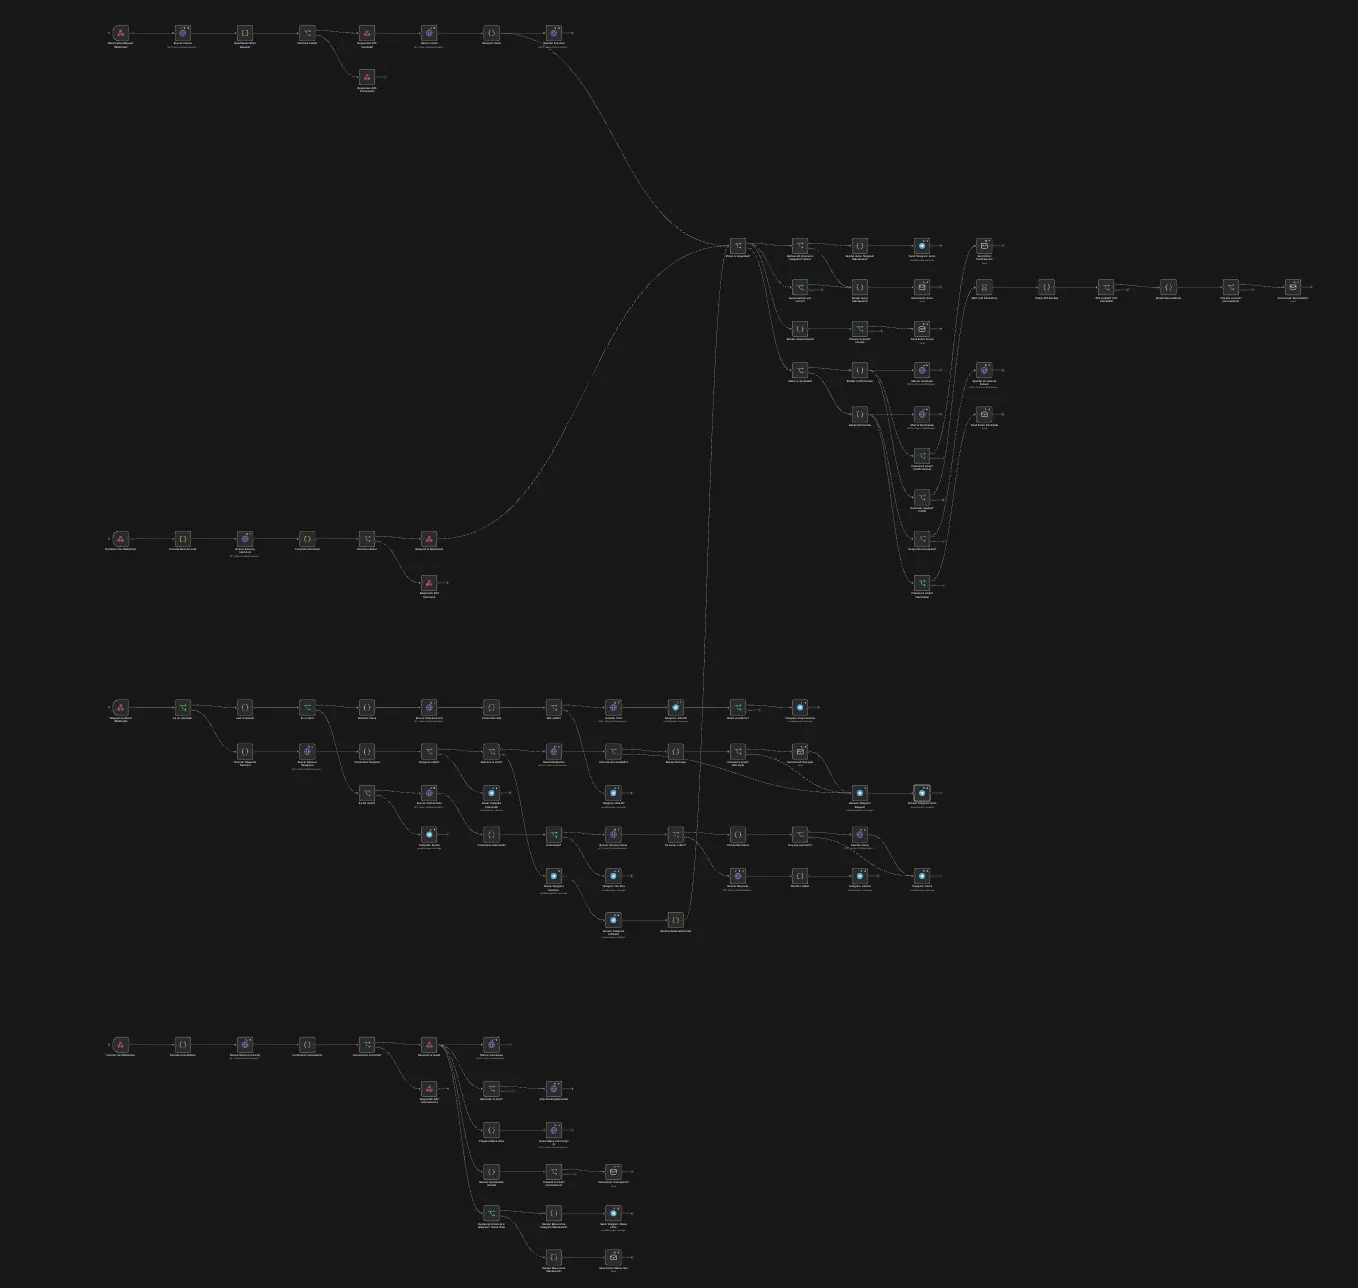
Flujos sobre un servidor n8n autoalojado. El flujo de reservas para restaurantes está en producción: la solicitud llega al propietario por Telegram, la acepta o rechaza desde el móvil y el cliente recibe confirmación y recordatorio. Junto a él funcionan una lista de espera de mesas libres y una solicitud de reseña al día siguiente; su verificador automático pasó 453, 148 y 56 comprobaciones con 0 fallos. Cinco flujos más para clínicas dentales están desplegados a la espera de la credencial del proveedor de mensajería.
Figura: el editor de n8n con la automatización de reservas de restaurantes y sus flujos relacionados (webhook, ramas, nodos de Telegram y correo).
Marca y contenido
Una guía de marca y un paquete de contenido orgánico producidos con IA, ahora en revisión: 8 series de carruseles con 102 diapositivas, 2 vídeos cortos terminados, 3 vídeos publicitarios producidos, y 22 archivos de vídeo y 203 imágenes en la carpeta de marketing.
Productos y sistemas propios
AStar
Junio 2026 – actualidad
Fundador
En desarrollo · demo privada prevista para diciembre de 2026 · aún sin enlace público
Un entrenador de exámenes con IA para Business y Economics de Edexcel IAL. Corrige respuestas, propone preguntas y guía el repaso usando los exámenes, esquemas de corrección e informes del examinador reales del tribunal.
Next.js
TypeScript
Claude API
Supabase
PostgreSQL + pgvector
Embeddings
15 AI skills
Contexto
Los exámenes premian aplicar la teoría a casos actuales y responder como lo espera el tribunal. Un chatbot general corrige sin ver el esquema de corrección, así que sus notas son difíciles de creer. Los agentes de la primera versión de AStar leían 17 notas escritas a mano y ninguno de los exámenes reales.
Solución
Una base de conocimiento vectorial con los exámenes, esquemas, informes del examinador y libros de texto reales, recuperados por pregunta. Hay un examinador y un generador de preguntas por asignatura, cada generador revisado por un comprobador de esquema, además de un entrenador de estudio, un tutor de noticias, un agente de diagramas y un enlazador de temario. Cada agente cita lo que recibió y la corrección se hace contra el esquema de esa pregunta. Una capa de calibración acerca la nota del examinador a la que dieron examinadores reales a respuestas parecidas.
Resultados
A 1 punto de la nota del examinador real en el 88 % de 33 respuestas de otros alumnos en la prueba del 3 de noviembre (82 % tras el último paso de calibración)
A 1 punto de la nota del examinador real en el 70 % de 30 respuestas que nunca había visto (prueba del 1 de noviembre)
Un 33 % más cerca del examinador que Claude sin más en las mismas respuestas
2.470 preguntas reales de examen, cada una con su esquema de corrección
Revisión de seguridad cerrada el 2 de noviembre de 2026 sin puntos abiertos
En cifras
Unas 85.500 líneas de código en 627 archivos y 606 commits desde el 13 de junio de 2026, contados el 3 de noviembre.
27 páginas, 41 rutas de servidor, 15 agentes de IA especialistas y 18 migraciones de base de datos, con seguridad por filas en las 33 tablas y vistas.
Una base de conocimiento hecha con el material del propio tribunal: 586 documentos, 2.470 preguntas de examen cada una con su esquema de corrección, 8.309 observaciones de examinadores y 1.320 reglas de corrección extraídas de los informes, y 681 respuestas reales corregidas por examinadores de Pearson guardadas como material de prueba.
167 notas de tema, una por cada punto del temario de Business y Economics de Edexcel International A-level, escritas a partir del temario, los esquemas y los informes y luego verificadas (en la ronda de Economics, 111 afirmaciones comprobadas y 26 corregidas), más 160 términos de glosario y 643 figuras de exámenes catalogadas.
140 diagramas de 36 tipos dibujados por código, no por la IA, cada uno comprobado contra solapamientos en portátil y móvil y contra errores de economía. El agente de diagramas eligió y dibujó el correcto 30 de 30 veces, en 1,4 segundos de mediana.
Un escáner de escritura a mano que leyó correctamente el 97,4 % de 3.950 palabras manuscritas y encontró 33 de 33 respuestas en 3 exámenes.
Una revisión de seguridad de 8 áreas antes de salir a internet, con cada comprobación en OK o corregida. Pasan 175 comprobaciones de seguridad, 116 ataques reales con solo la clave pública fueron rechazados y no aparece ninguna clave secreta en 581 commits. Encontró y cerró fallos reales: una ruta que daba IA ilimitada gratis, un código de invitación que abría cuentas ilimitadas y 20 llamadas simultáneas que se saltaban un límite. Dos correcciones se reabrieron a propósito y las pruebas fallaron las dos veces.
Pruebas ejecutadas de nuevo el 3 de noviembre, todas en verde: 798 pruebas de diagramas, 28 archivos de prueba del flujo de conocimiento, 57 archivos de prueba de la app y 130 archivos de prueba en total, con modelos simulados para que no cuesten nada.
Comprobaciones a ciegas del propio trabajo de la IA: etiquetado de noticias por tema, 0 errores de 45 (antes, 31 de 45 estaban mal o incompletas); el generador de preguntas pasó 24 de 24 tras sus comprobadores de esquema; y el entrenador asoció 1.508 de 1.508 preguntas a su propia unidad.
Precisión medida
El conjunto de prueba son 30 respuestas reales de examen que examinadores de Pearson Edexcel habían corregido. AStar no las había visto nunca y nada se ajustó con ellas. Claude sin más es Claude Sonnet 5.5 con la pregunta, el esquema real y la respuesta. La diferencia es la que hay entre la nota del programa y la del examinador.
AStar
Claude sin más
A 1 punto o menos del examinador
70 %
40 %
Diferencia media, las 30 respuestas
1,5 puntos
2,2 puntos
Diferencia media, Business (14 respuestas)
2,3 puntos
3,3 puntos
Diferencia media, Economics (16 respuestas)
0,8 puntos
1,3 puntos
Medido el 1 de noviembre de 2026 tras la calibración. Antes de calibrar, AStar quedaba a 1 punto o menos en el 40 % de las mismas respuestas. El objetivo es el 90 % y AStar aún no lo alcanza. La muestra es pequeña: con 30 respuestas, una sola respuesta mueve el porcentaje unos 3 puntos. La calibración se ajustó con otras 112 respuestas, nunca con las 30.
Última prueba, 3 de noviembre de 2026
Se probó una versión más nueva del examinador con 33 respuestas reales de examen escritas por otros alumnos y corregidas por examinadores de Pearson. Antes del paso de calibración quedó a 1 punto o menos del examinador en el 88 % de ellas, a 2 puntos o menos en el 97 %, con una diferencia media de 0,8 puntos. Con el paso de calibración, que es lo que ve un alumno, las cifras fueron 82 %, 91 % y 0,9 puntos. Una segunda ejecución con 33 respuestas leídas por la app a partir de escritura a mano escaneada, no de texto tecleado, dio 73 % antes y 67 % después de calibrar, con una diferencia media de 1,0 y 1,2 puntos. Ambos conjuntos son pequeños y no son las 30 respuestas reservadas de arriba, así que los muestro junto a ellas, no en su lugar. El objetivo sigue siendo el 90 % en respuestas que el examinador no ha visto nunca.
Antes de calibrar
Con calibración
A 1 punto o menos (33 respuestas)
88 %
82 %
A 2 puntos o menos (33 respuestas)
97 %
91 %
Nota exacta (33 respuestas)
39 %
42 %
Diferencia media (33 respuestas)
0,8 puntos
0,9 puntos
A 1 punto o menos (escritura a mano escaneada, 33 respuestas)
73 %
67 %
Fuente: los archivos de resultados de la prueba del 3 de noviembre de 2026 del archivo de métricas de AStar, copiados tal cual. Las notas con las que se compara son las que dieron los examinadores de Pearson en los exámenes devueltos.
La base de conocimiento
Contado en la base de datos el 2 de noviembre de 2026: 586 documentos (188 exámenes, 186 esquemas de corrección, 133 informes del examinador, notas de corte y especificaciones), 2.470 preguntas de examen, 681 respuestas reales de alumnos con la nota del examinador, 8.309 observaciones de examinadores y 1.320 reglas de corrección extraídas de los informes, 3.098 fragmentos de dos libros de texto gratuitos, 205 temas del temario y 36 tipos de diagrama.
Cómo funciona
Ingesta
Los PDF se convierten a texto, con OCR para los escaneados, y un script copia las palabras exactas del tribunal en fichas. El criterio de Claude (temas y verbos de instrucción) se guarda aparte, para no mezclar lo copiado con lo interpretado.
Verificación
Un comprobador demuestra cada cita palabra por palabra contra su fuente. Una cita falsa plantada a propósito demuestra que el comprobador puede fallar, y el ayudante de commits se niega a guardar mientras haya un error.
Recuperación
La búsqueda filtra primero por especificación, unidad, puntuación, verbo de instrucción y tema, y después ordena por significado y coincidencia de palabras. Si hay menos de dos preguntas, relaja los filtros uno a uno. Los esquemas y los niveles de corrección se piden por identificador exacto, no por búsqueda.
Trazabilidad
Cada fragmento lleva su identificador, el agente lo cita, el servidor comprueba la cita contra lo que se envió de verdad y la pantalla muestra «Corregido contra» con la fuente.
Seguridad
Una revisión escrita, cerrada el 2 de noviembre de 2026: límites de tamaño en cada llamada al modelo, protección frente a inyección de instrucciones en cada agente, límites de peticiones, almacenamiento privado para los exámenes y una cuenta por código de invitación.
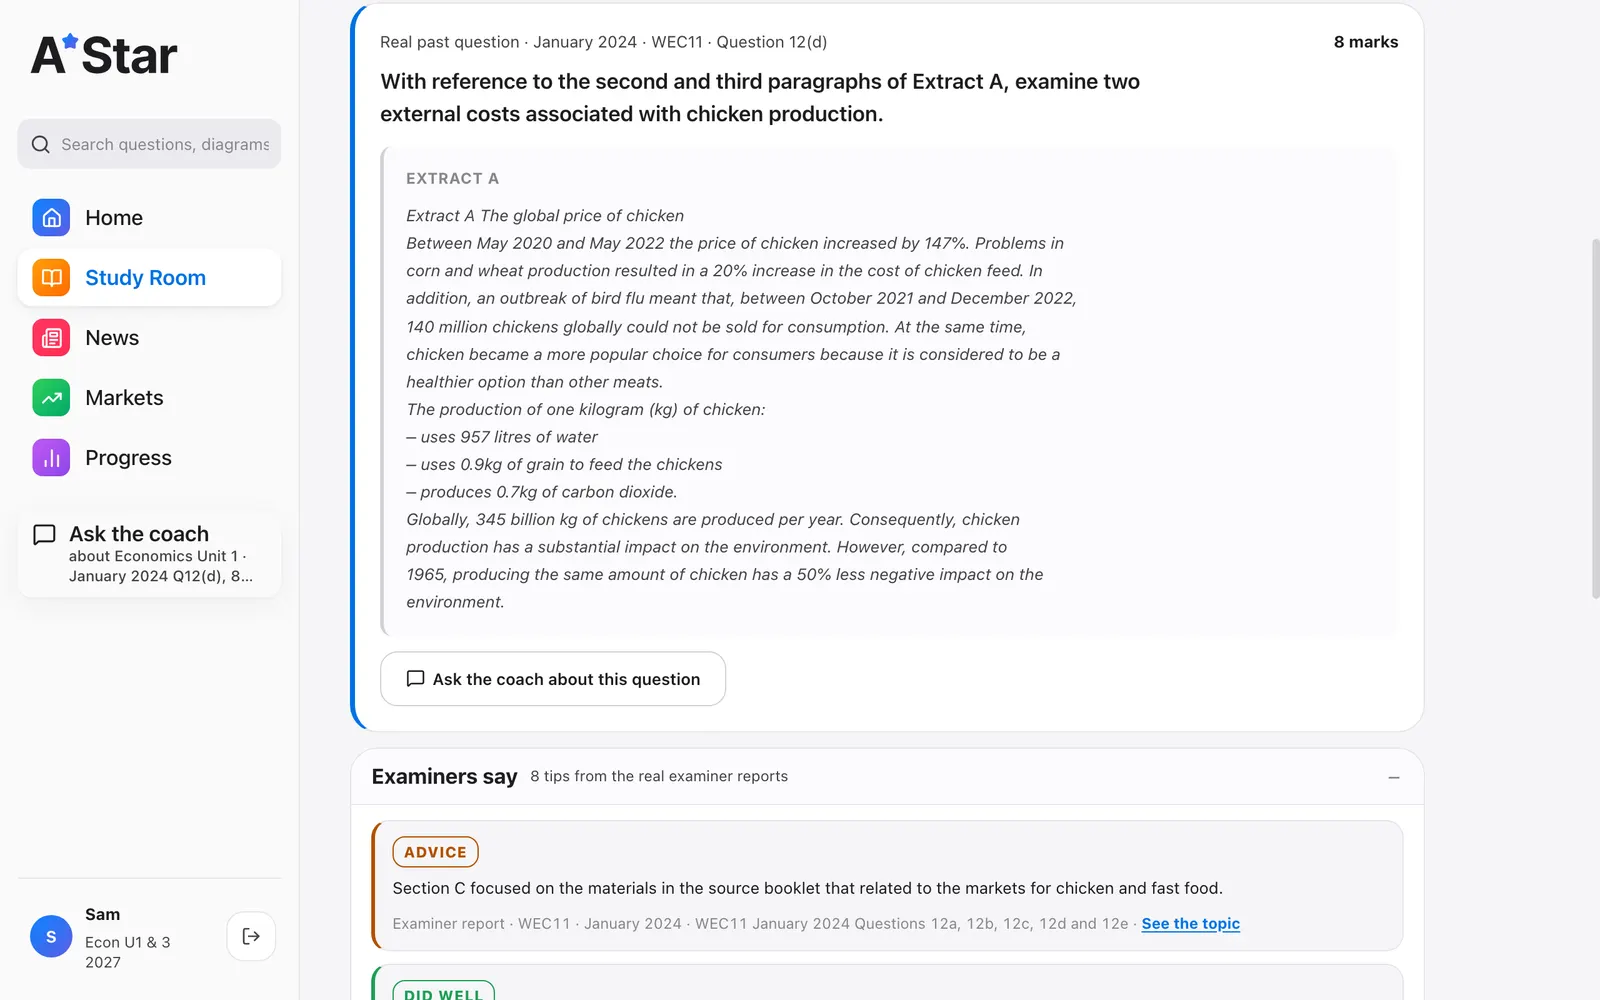
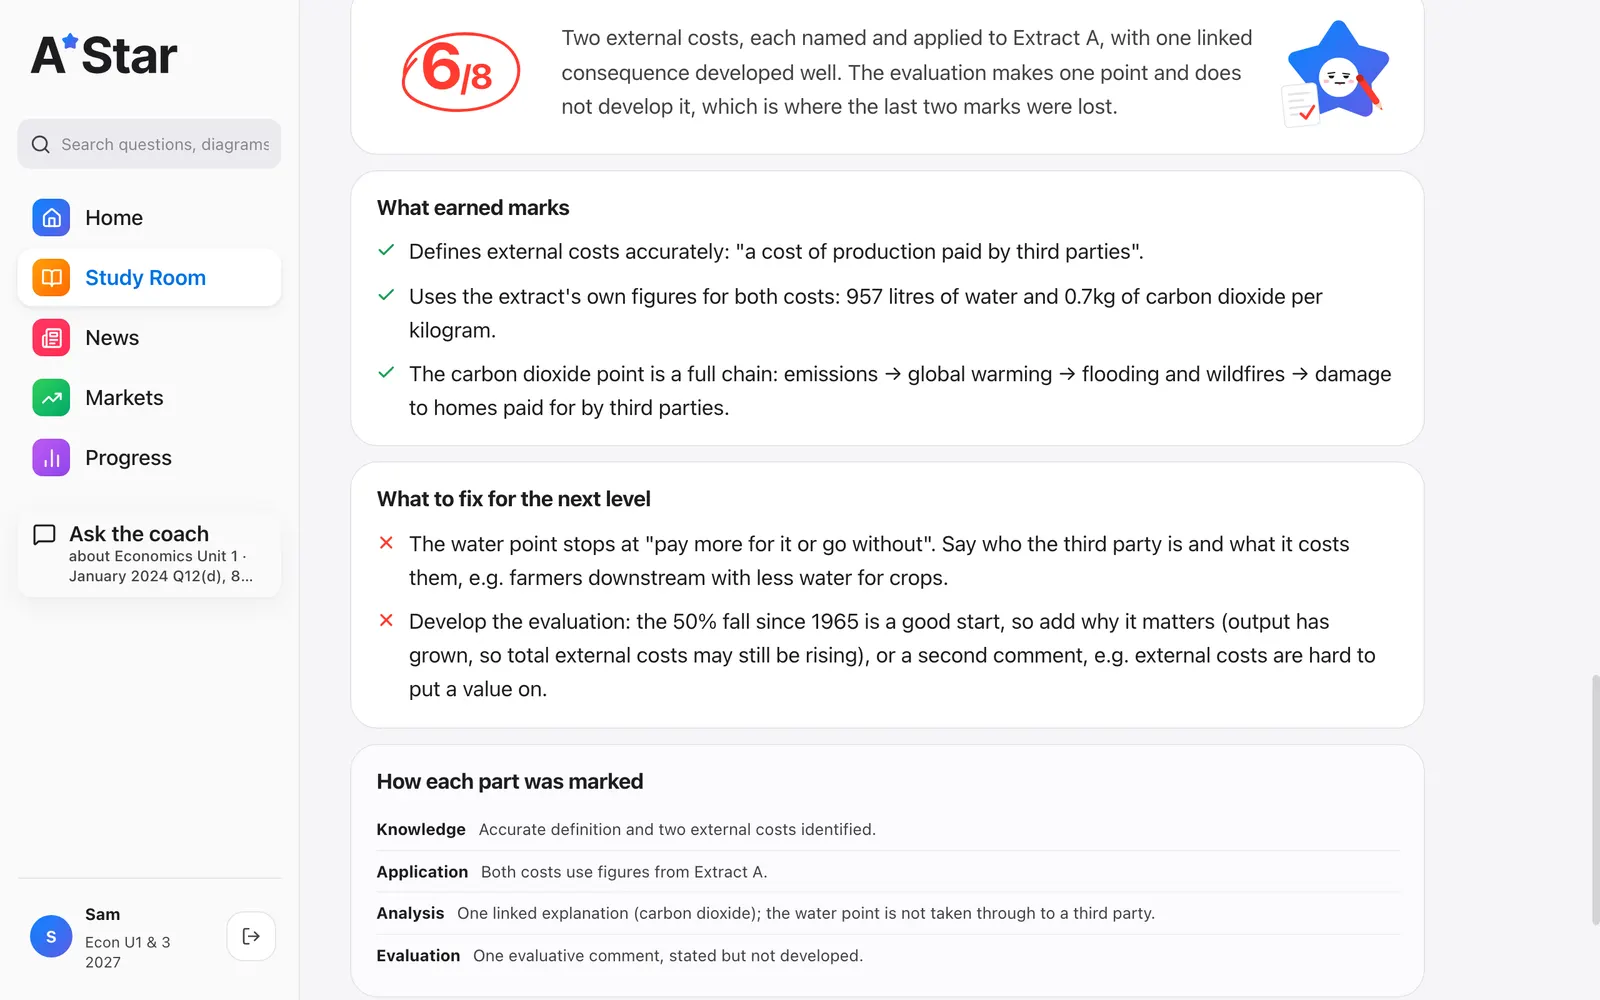
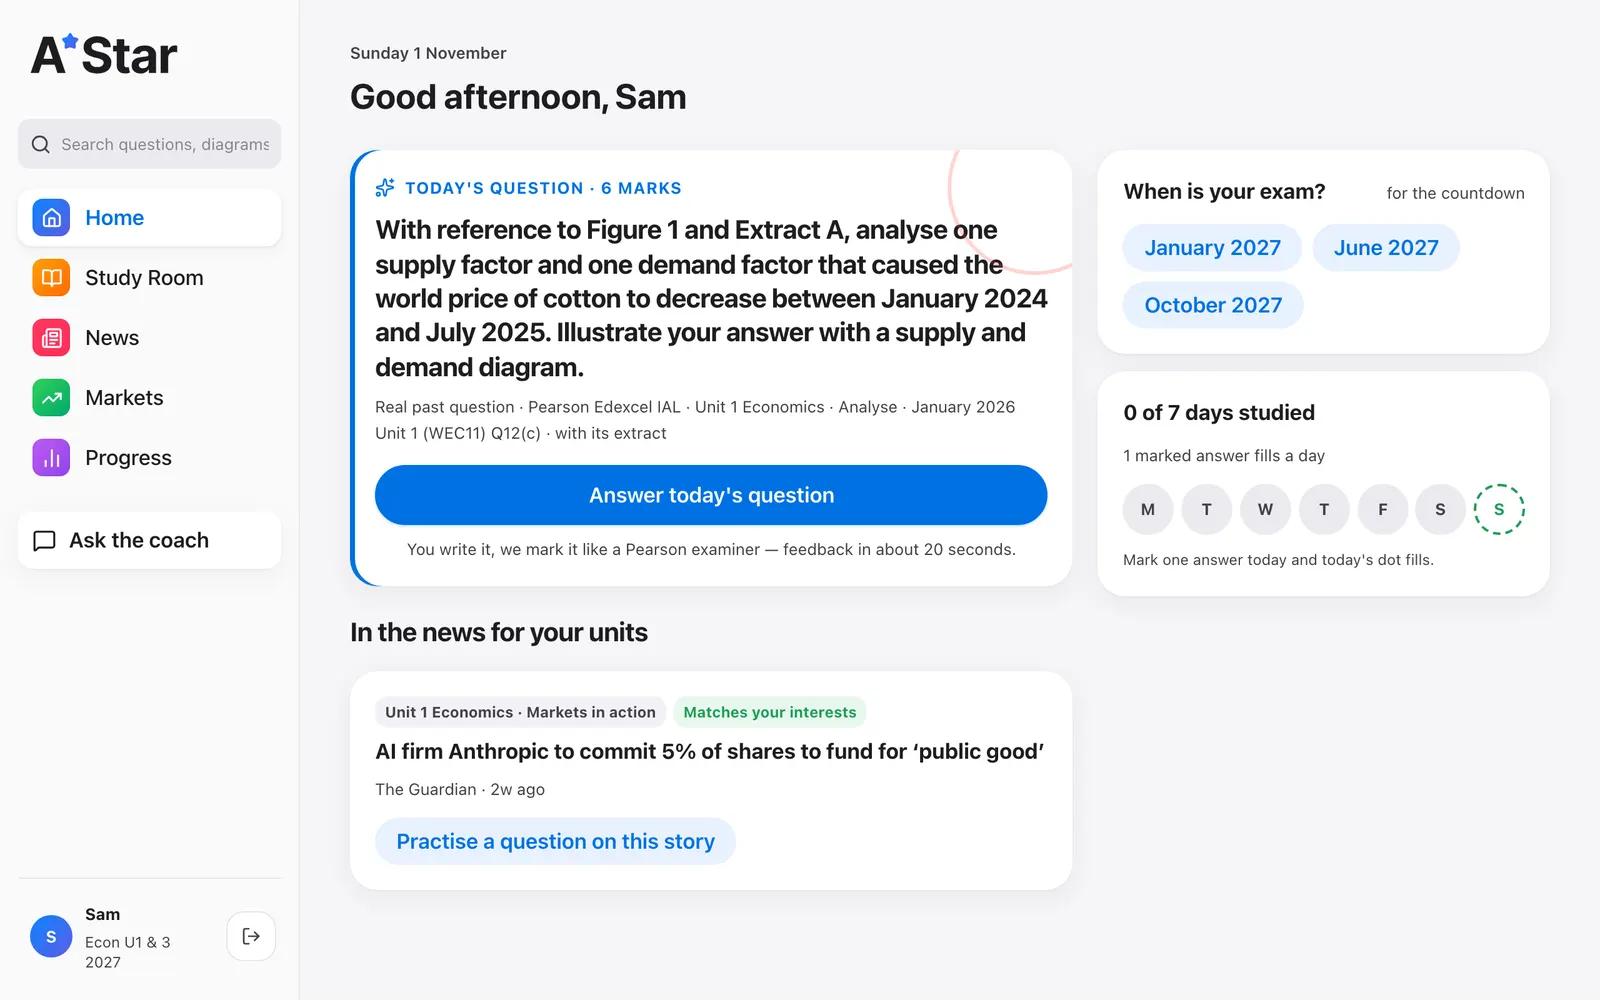
Figura: la Study Room muestra una pregunta real de examen con su extracto y los consejos del examinador.Figura: el examinador corrige una respuesta con 6 sobre 8, con lo que sumó puntos, qué corregir y la nota de cada objetivo de evaluación. La cuenta es de un usuario de demostración.
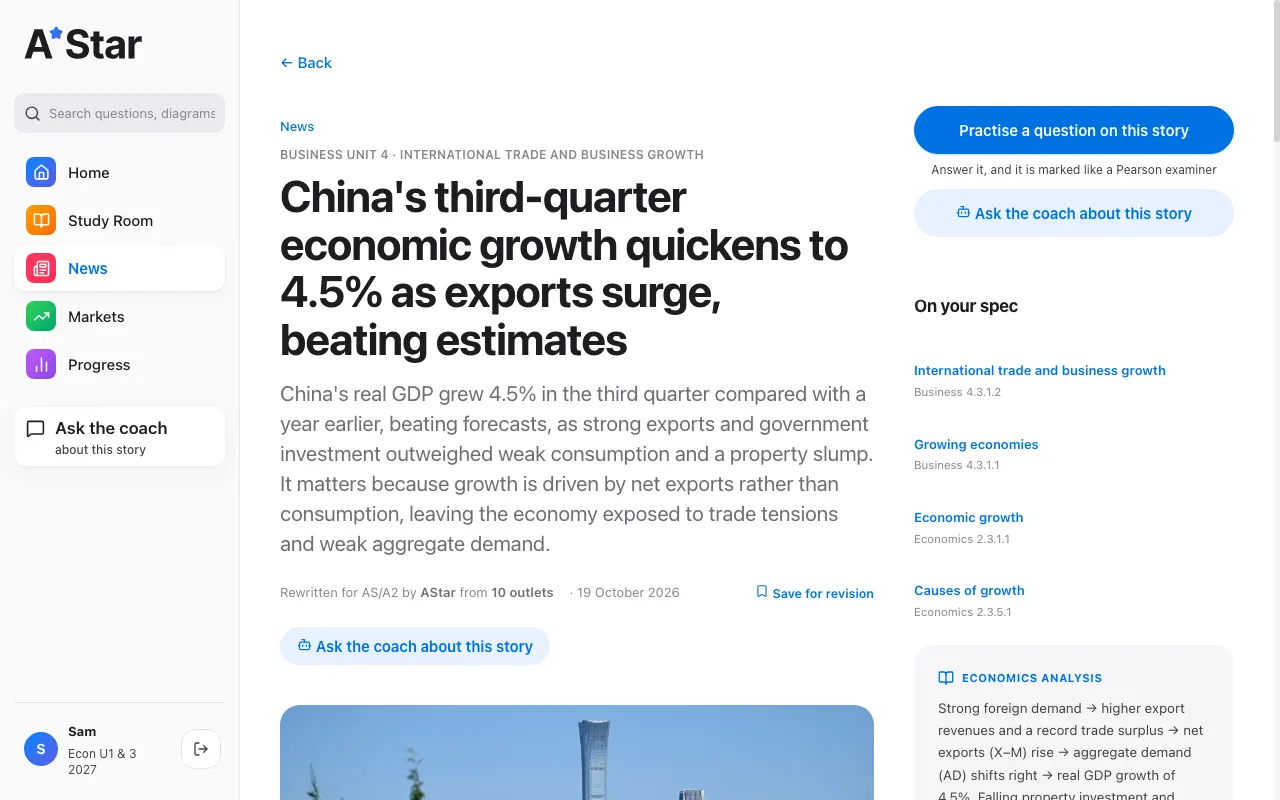
Figura: la pantalla de inicio de AStar.Figura: una noticia enlazada con el temario.
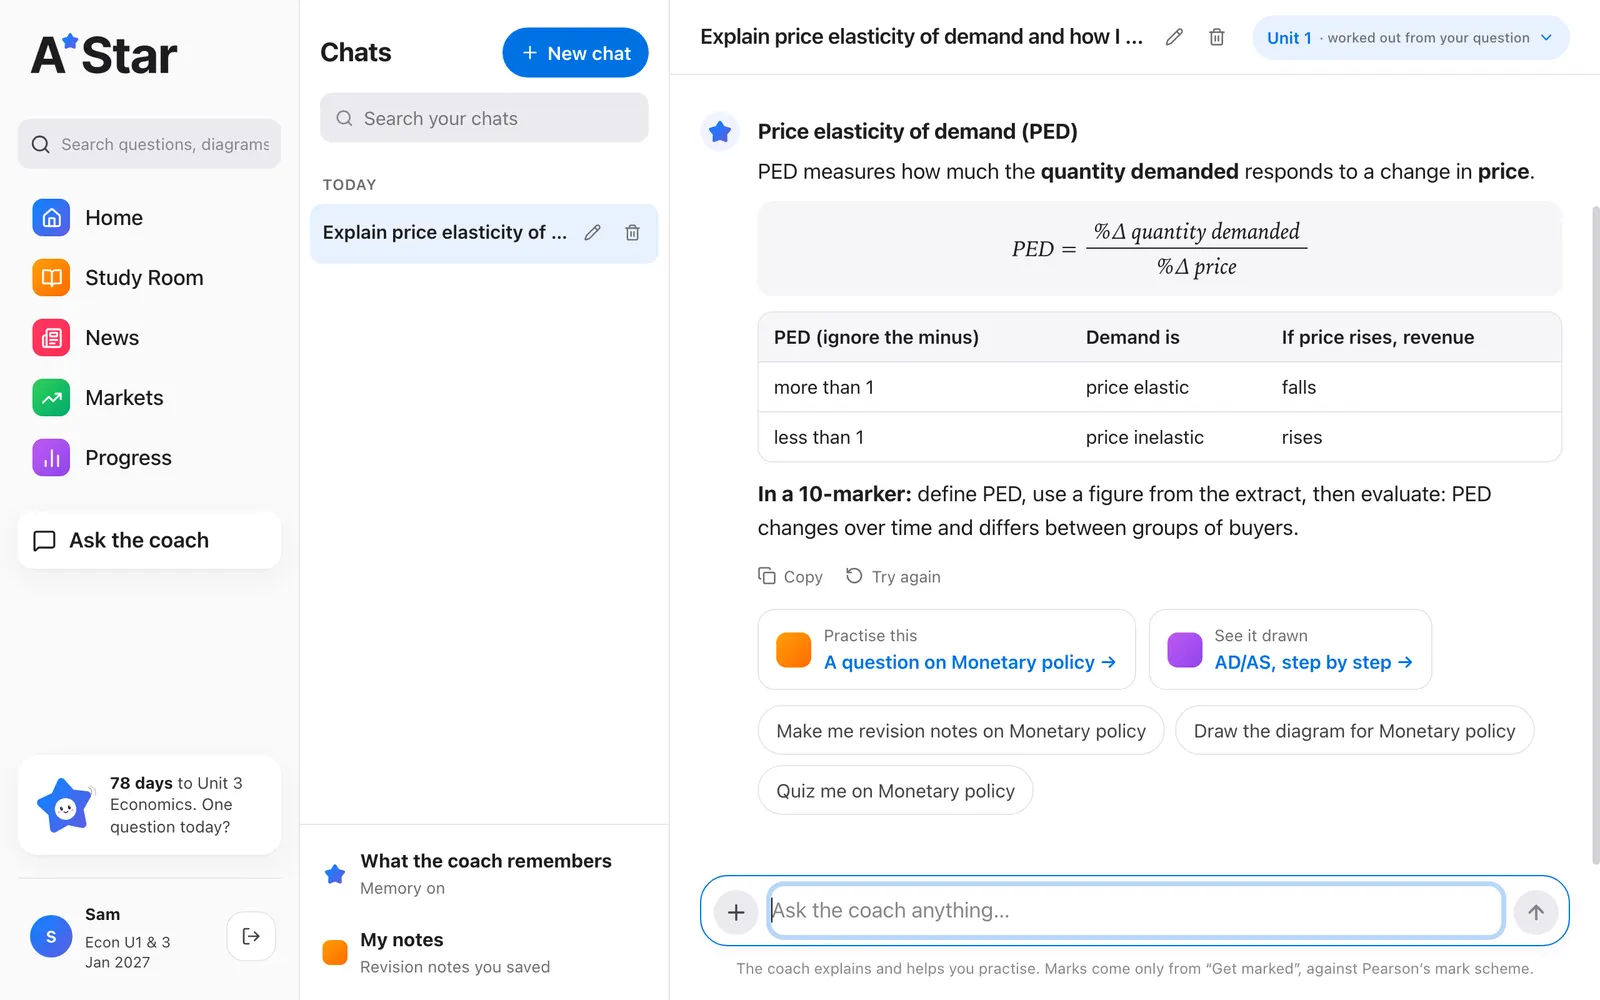
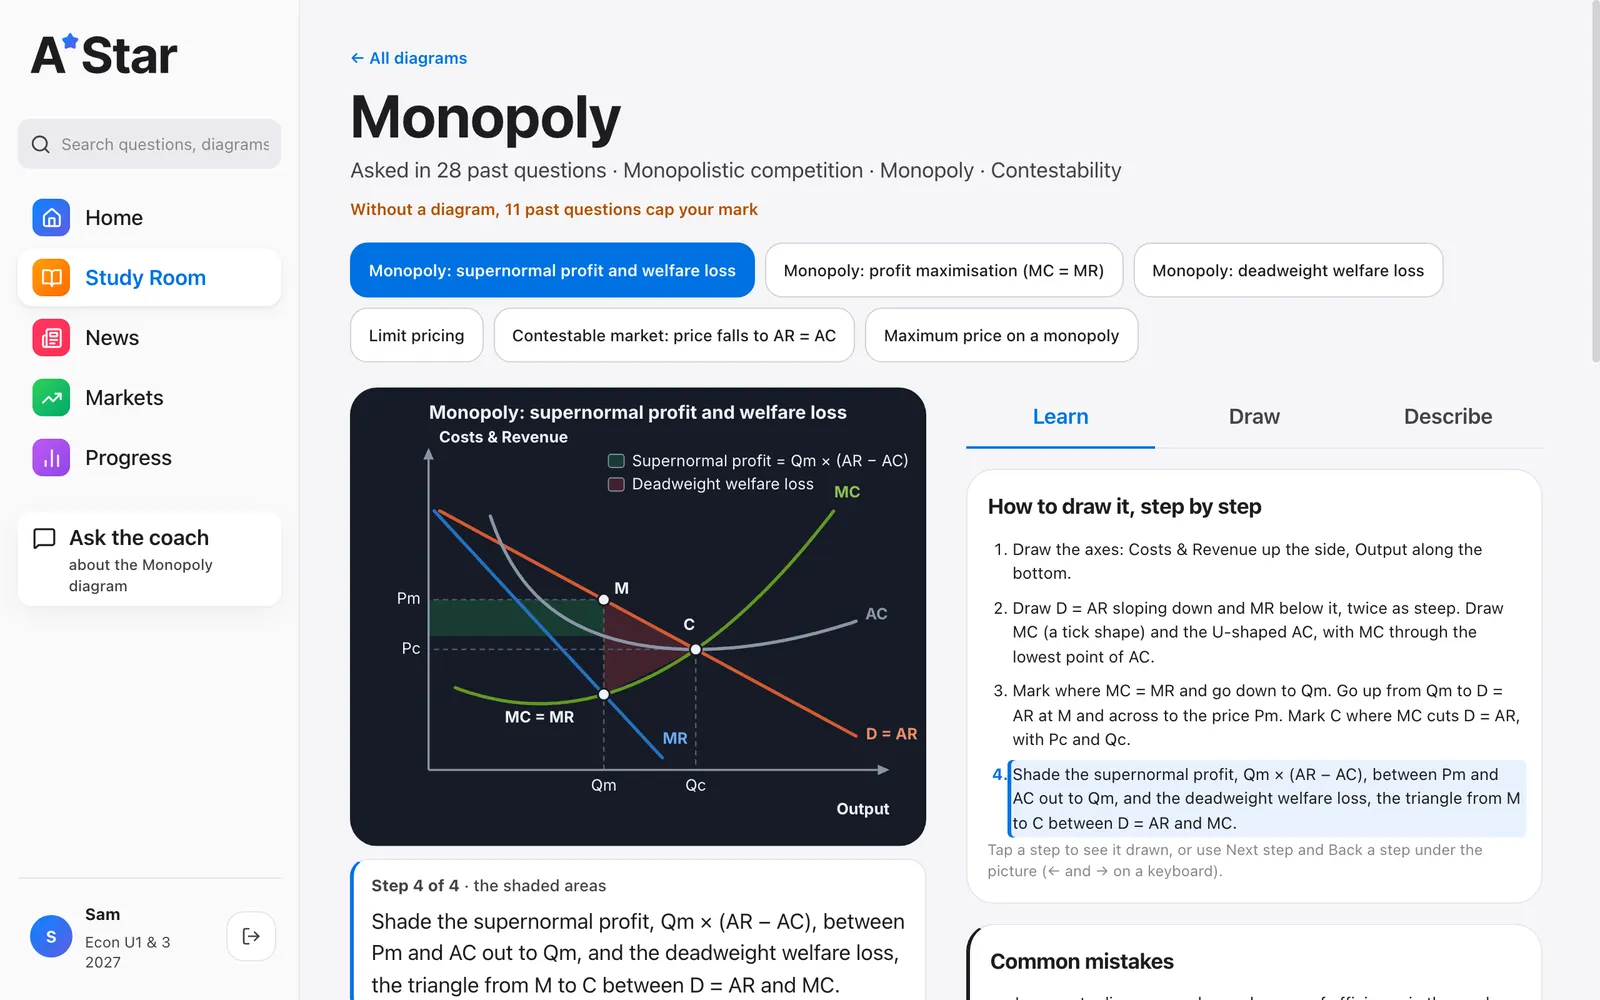
Figura: el entrenador responde una duda de repaso y mantiene una memoria del alumno.Figura: una página de diagrama con pestañas Aprender, Dibujar y Describir y una guía paso a paso.
AStar todavía no lo usan alumnos reales. La demo será privada y con código de invitación, para medir el coste y la calidad reales por alumno antes de cualquier lanzamiento. Más adelante: más tribunales y asignaturas, cuentas y pagos, y el permiso de los tribunales para su material antes de vender nada.
Sistema de agentes personal
2026 · en uso diario
Arquitecto y usuario diario
Un entorno de trabajo en el que un orquestador planifica, un agente por proyecto ejecuta y un revisor independiente evalúa el resultado.
Claude Code
Python
Obsidian
Hooks
Scheduled tasks
11 projects
22 agents
24 skills
Contexto
Trabajar con un chat no escala: cada conversación empieza de cero, las decisiones se pierden y quien ejecuta acaba aprobando su propio trabajo.
Solución
Roles separados. El orquestador escribe órdenes con objetivo, contexto, límites y criterio de cierre. Un agente ejecutor por proyecto hace el trabajo. Un revisor de solo lectura lo evalúa contra el estándar escrito del proyecto y decide si hace falta otra ronda. Cada proyecto tiene un plan que se actualiza en el mismo paso que el trabajo, y mis correcciones se convierten en estándares que aplican los revisores.
Resultados
Trabajo autónomo en bucles de hasta 5 rondas
11 scripts de hooks, algunos de ellos bloqueos que no se pueden saltar
Toda ejecución desatendida se puede deshacer
22 scripts auxiliares con 15 archivos de prueba, cada comprobación probada con un error sembrado
En cifras
22 agentes: 11 ejecutores y 11 revisores de solo lectura, un par para cada uno de los 11 proyectos activos. Los revisores solo pueden leer, por diseño, así que no pueden arreglar lo que juzgan.
Unas 35.000 líneas de Python en 139 archivos: hooks, scripts y dos paneles, contados el 3 de noviembre.
215 casos de prueba sembrados pasan en 13 de 15 baterías (las otras 2 prueban los hooks de un proyecto retirado). 77 de ellos están demostrados eliminando la comprobación que prueban y viendo que fallan.
El sistema se contrasta a sí mismo con el disco: 17 comprobaciones en OK, 0 rotas y 0 no comprobables en la última ejecución.
416 sesiones de Claude Code registradas automáticamente a lo largo de 84 días entre el 15 de julio y el 3 de noviembre de 2026, con las claves eliminadas de cada registro.
184 cambios de reglas registrados por el hook que hace que cada cambio de una regla llegue a todos los archivos de instrucciones, del 30 de septiembre al 3 de noviembre.
Un panel de 12 vistas y 35 rutas en unas 4.200 líneas de Python puro sin paquetes externos, construido en cuatro rondas el 2 de noviembre. Se sincroniza con Google Calendar cada 10 minutos y ejecuta en segundo plano una tarea de la cola en menos de 20 segundos, con opción de deshacer.
3 tareas programadas que funcionan solas: un investigador diario, un periódico nocturno y una revisión de los domingos.
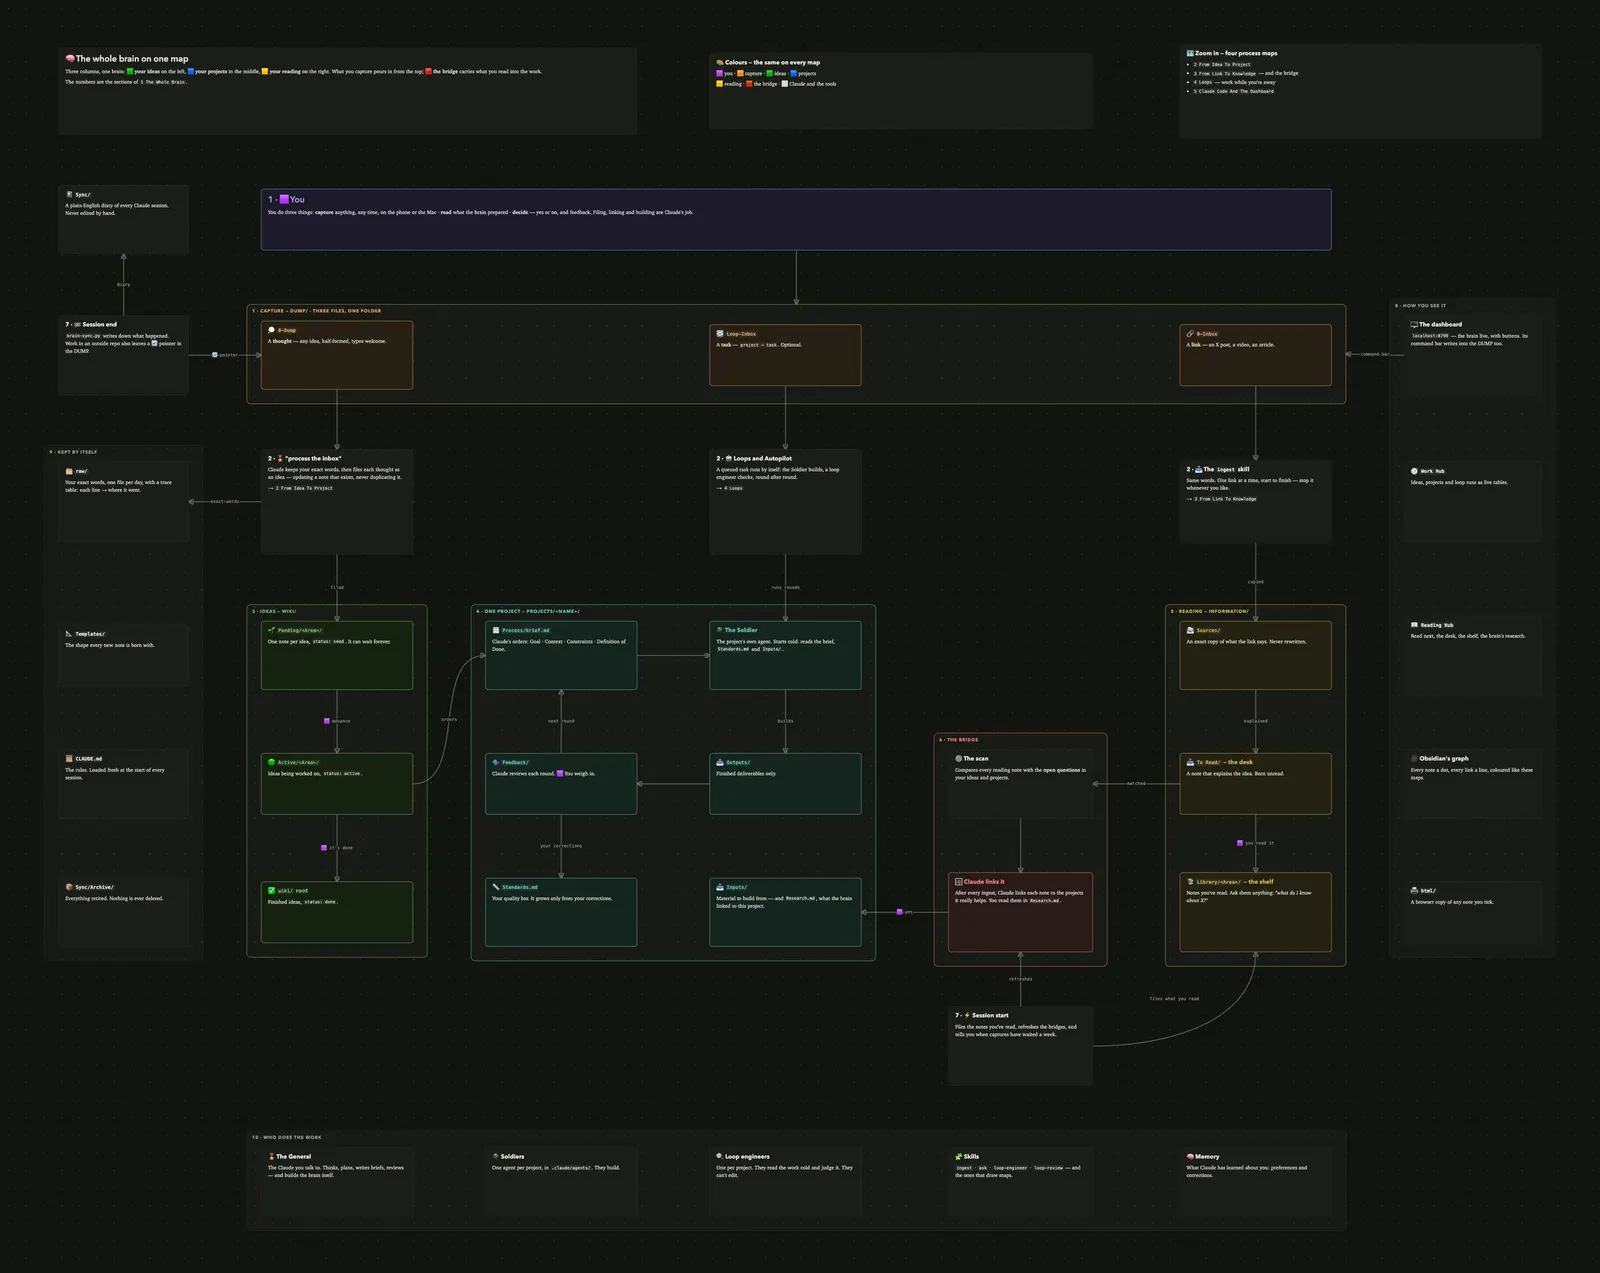
Figura: el sistema completo: captura, ideas, proyectos, lectura y ejecución automática. Copia exacta del canvas de Obsidian.
Detalles técnicos
verify-live.py contrasta lo que el sistema declara con lo que hay en el disco y devuelve OK, ROTO o NO COMPROBABLE. Lo no comprobable nunca se cuenta como aprobado.
Las reglas que se incumplen se promueven, no se reescriben: de documento a lista de control, a comprobación que suspende la ronda y a bloqueo. Entre los bloqueos hay uno que protege registros reales de empleados y otro que impide que la IA escriba los campos que solo son míos.
Un filtro de seguridad impide que cualquier clave secreta llegue al disco, con 20 formas de clave reconocidas, y además las elimina de los registros de sesión.
Un escudo de escritura guarda el original de cada archivo que toca una ejecución desatendida, de modo que toda la ejecución se deshace con un clic.
Un hook impide terminar un turno si el plan del proyecto no se actualizó después del trabajo, y otro hace que cada cambio de una regla llegue a todos los archivos de instrucciones.
Una skill fix investiga cómo resolvió la gente real un problema en foros, GitHub y comentarios de vídeo, puntúa cada solución por confirmaciones independientes y prueba ella misma las gratuitas.
Mi panel
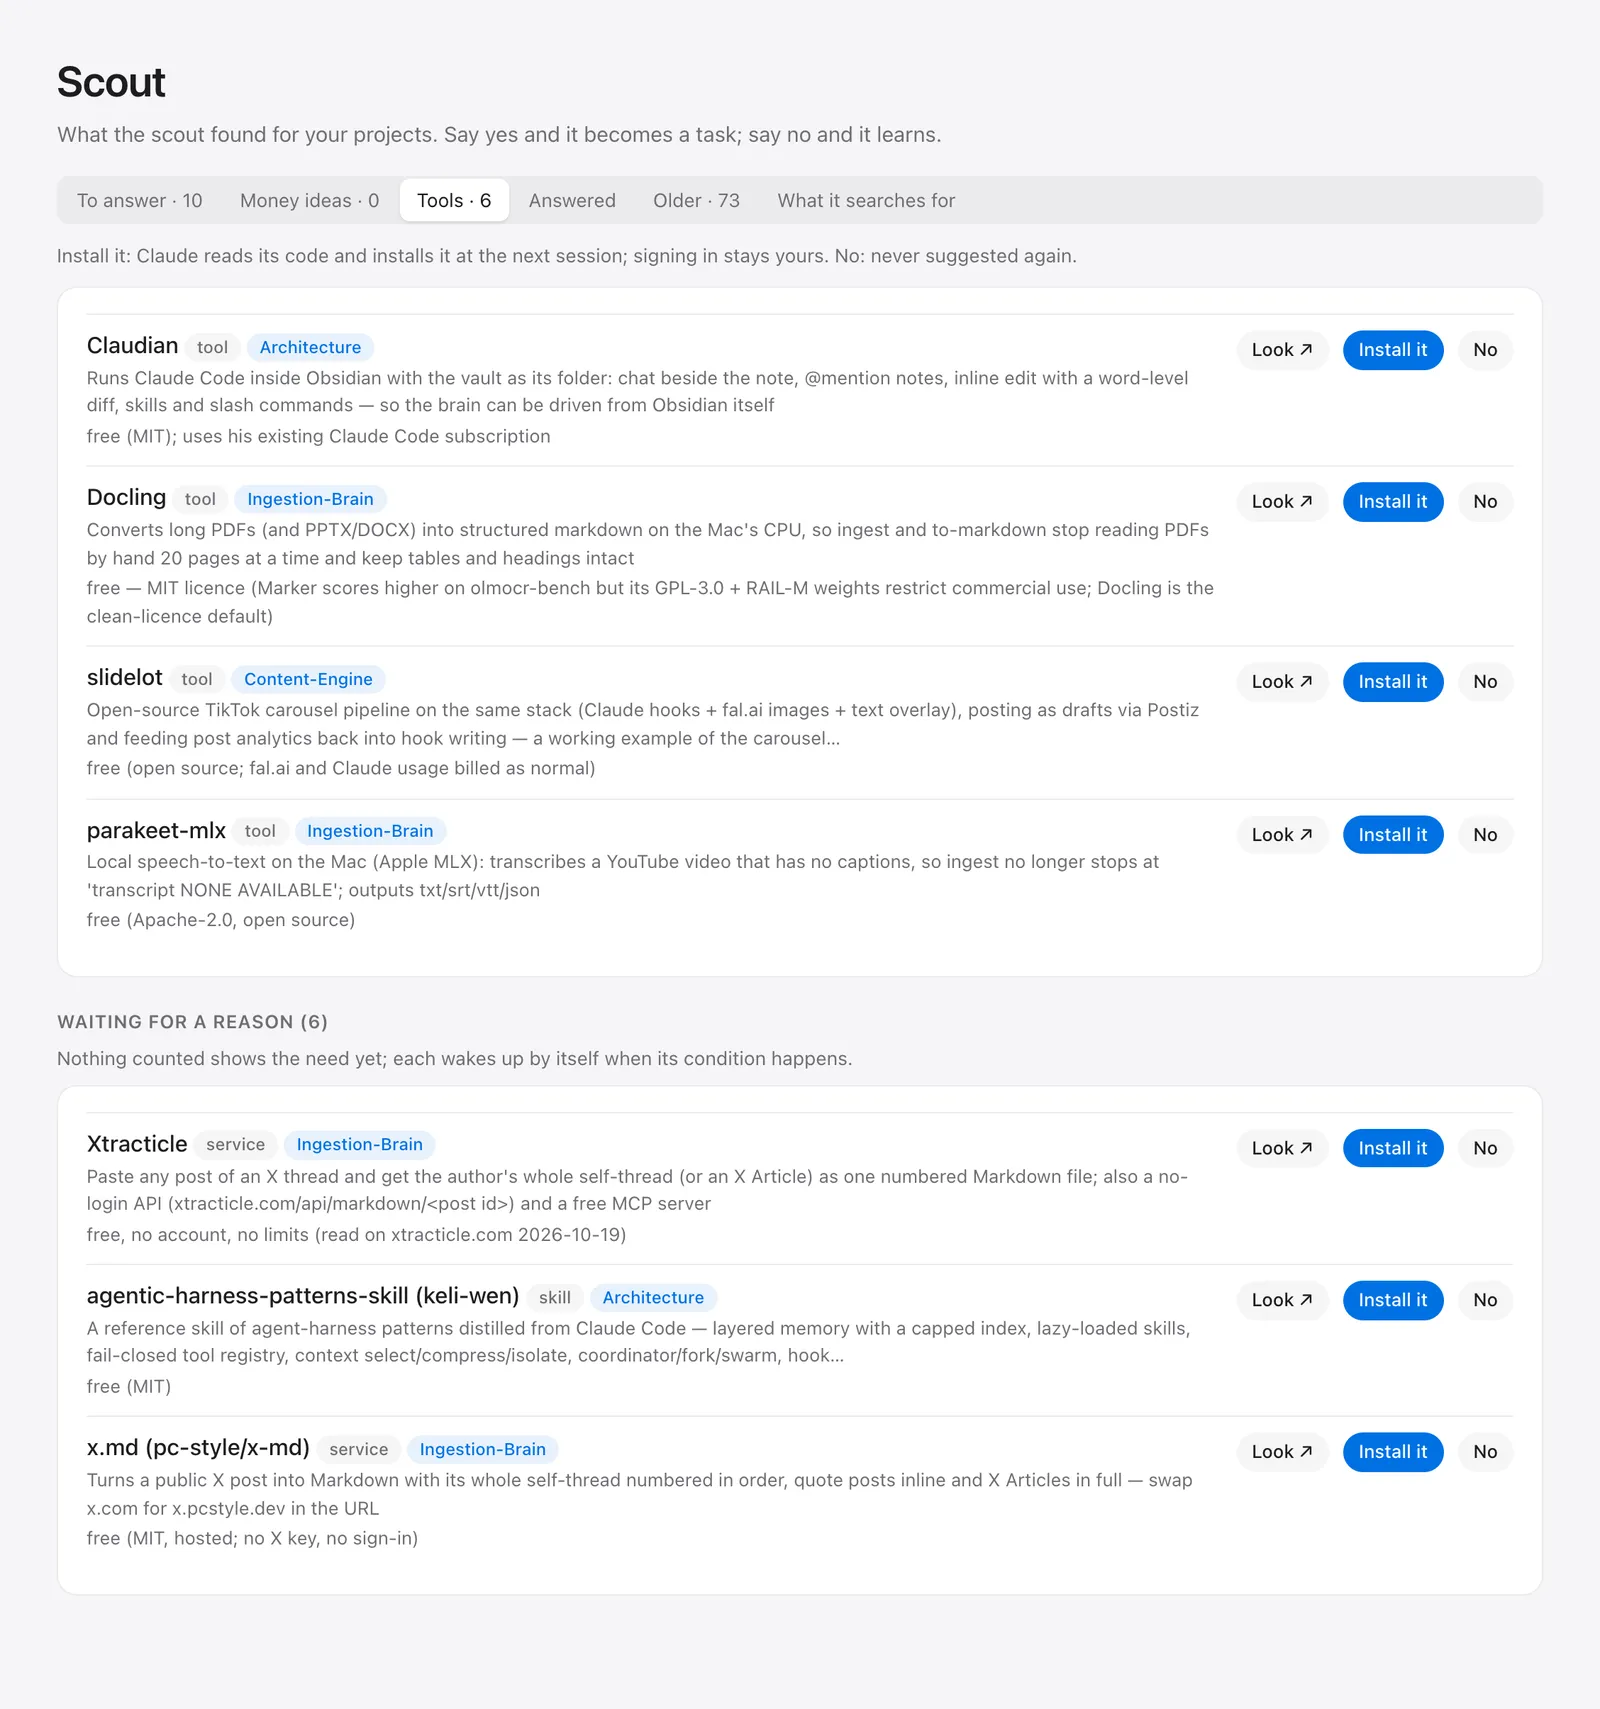
Un panel web que construí el 2 de noviembre de 2026 en cuatro rondas, en Python sin framework. Muestra mi día, mis proyectos con sus planes, un calendario sincronizado con Google Calendar, los hallazgos de investigación pendientes de un sí o un no, un grafo de conocimiento y un piloto automático que toma una tarea de la cola y la ejecuta en segundo plano, con opción de deshacer. Cada escritura es una línea validada en un archivo que el sistema ya define, con copia de seguridad previa. La vista de investigación lista las herramientas que encuentra el investigador sin instalarlas, y las que no tienen una necesidad contada esperan a que ocurra su condición.
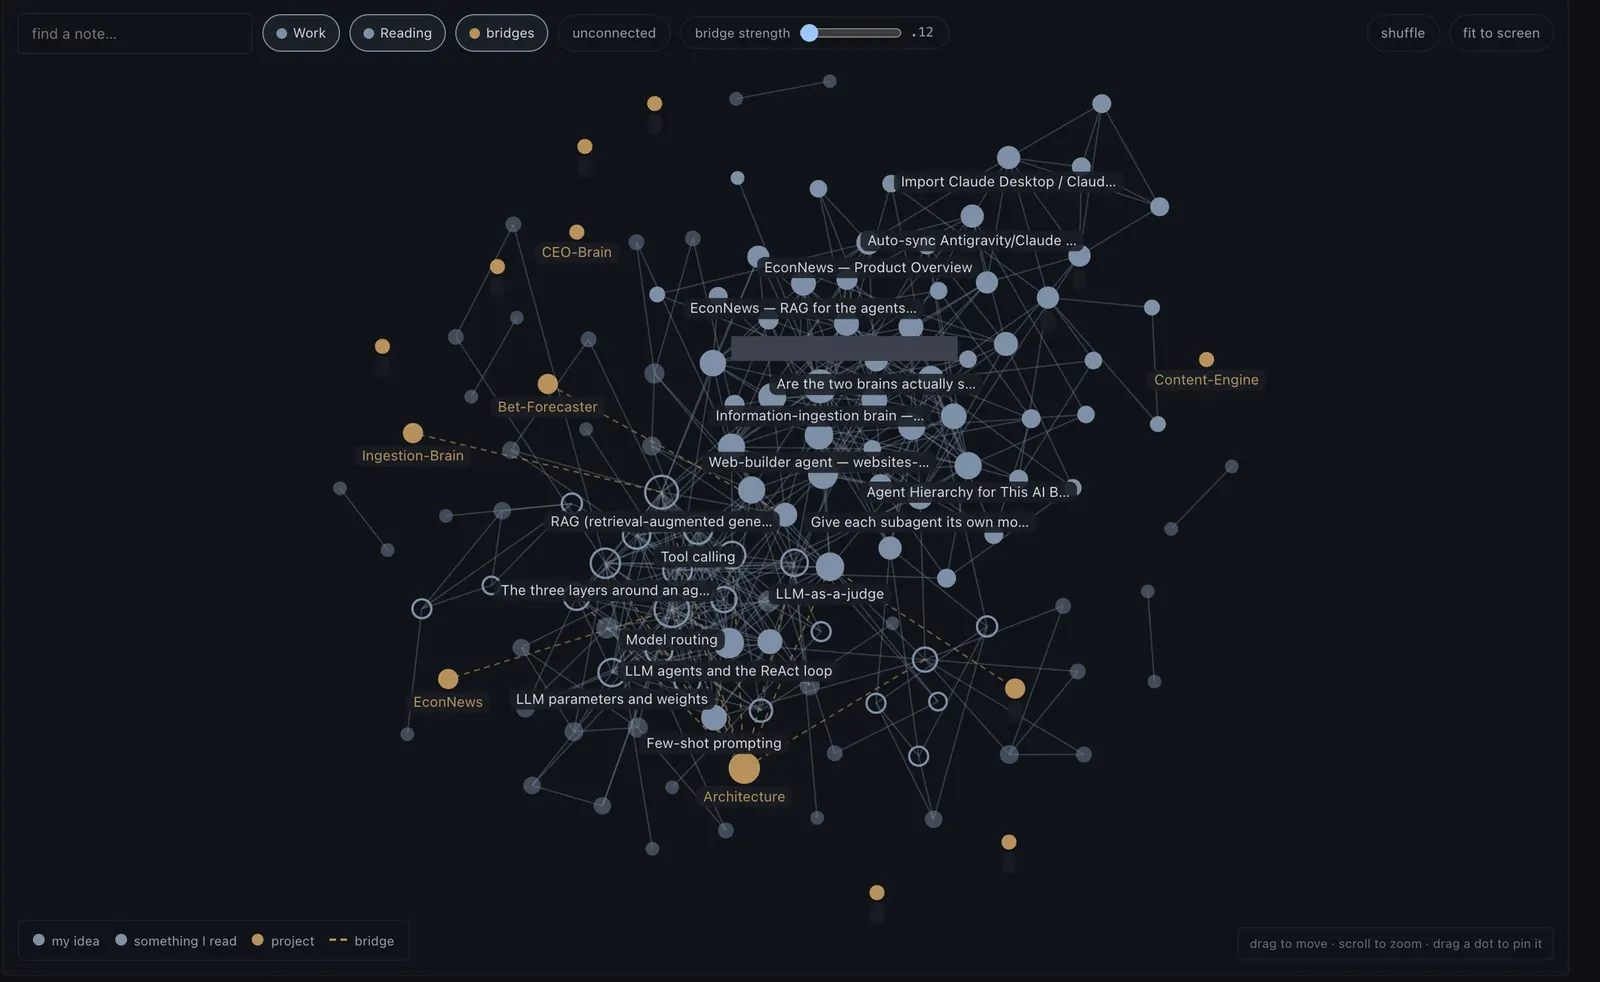
Figura: el grafo de conocimiento del panel: mis ideas y mis lecturas como puntos, los proyectos en naranja y líneas discontinuas donde una lectura ayuda a un proyecto. EconNews es el nombre anterior de AStar; se ha tapado el título de una nota que nombra a un tercero.Figura: la vista de herramientas del investigador. Las herramientas que encuentra solo se listan, con nota de licencia y coste, y yo elijo Instalar o No. Las que no muestran una necesidad contada esperan en «Esperando una razón» hasta que ocurra su condición. Se han ocultado las filas con precios o con el nombre antiguo del proyecto.
Sistema de lectura
2026 · en uso diario
Arquitecto y usuario diario
Una tubería que convierte lo que leo en conocimiento y lo conecta con los proyectos a los que aporta. Encima funcionan un investigador diario y un periódico nocturno.
Claude Code skills
Python
TF-IDF
Scheduled tasks
152 sources
65 research notes
Contexto
Los enlaces guardados rara vez llegan al proyecto donde serían útiles.
Solución
Extracción literal de la fuente y notas destiladas por idea. Un puente puntúa cada nota frente a las preguntas abiertas de cada proyecto con TF-IDF: las palabras que aparecen en todas partes, como «agente» o «modelo», pesan casi cero y los términos específicos, como «duckdb», deciden. Por encima de 0,25 el vínculo es fuerte, entre 0,12 y 0,25 merece una mirada y por debajo se descarta. Después un paso de evaluación lee la nota y el proyecto y solo crea el vínculo si aporta algo utilizable, con un máximo de tres proyectos por nota.
Resultados
152 fuentes guardadas literalmente y destiladas en notas, más 65 notas de investigación escritas para los proyectos
Las extracciones fallidas se registran como fallidas, nunca se reconstruyen
Un investigador diario que busca solo dentro de filtros que escribo y rechaza duplicados y todo lo que supere sus límites
Un periódico nocturno: 18 ediciones desde el 14 de octubre de 2026
En cifras
152 fuentes ingeridas a lo largo de 42 días entre el 16 de julio y el 3 de noviembre de 2026: 104 archivadas, 16 seguidas automáticamente desde enlaces internos y 2 registradas como fallidas en lugar de inventadas.
94 notas destiladas (65 notas de investigación escritas por el investigador diario, 23 en la mesa de lectura y 6 en la estantería) y 17 resúmenes semanales.
154 puentes entre una nota y una pregunta abierta de un proyecto: 84 aplicados, 62 rechazados y no vueltos a sugerir, 141 juzgados por Claude y no a mano.
Un investigador diario de 2.071 líneas con 47 casos de prueba sembrados, cada uno demostrado como fallido al apagar su comprobación, y una entrada de dos filtros que pregunta si el sistema ya tiene la herramienta y qué problema resuelve, con un número.
Una habilidad «fix» que busca en 218 lugares de 29 temas donde personas reales resolvieron un problema, y puntúa cada solución por confirmaciones independientes.
Un periódico interactivo escrito de madrugada por un agente programado: 18 ediciones fechadas con 265 noticias entre el 14 de octubre y el 3 de noviembre.
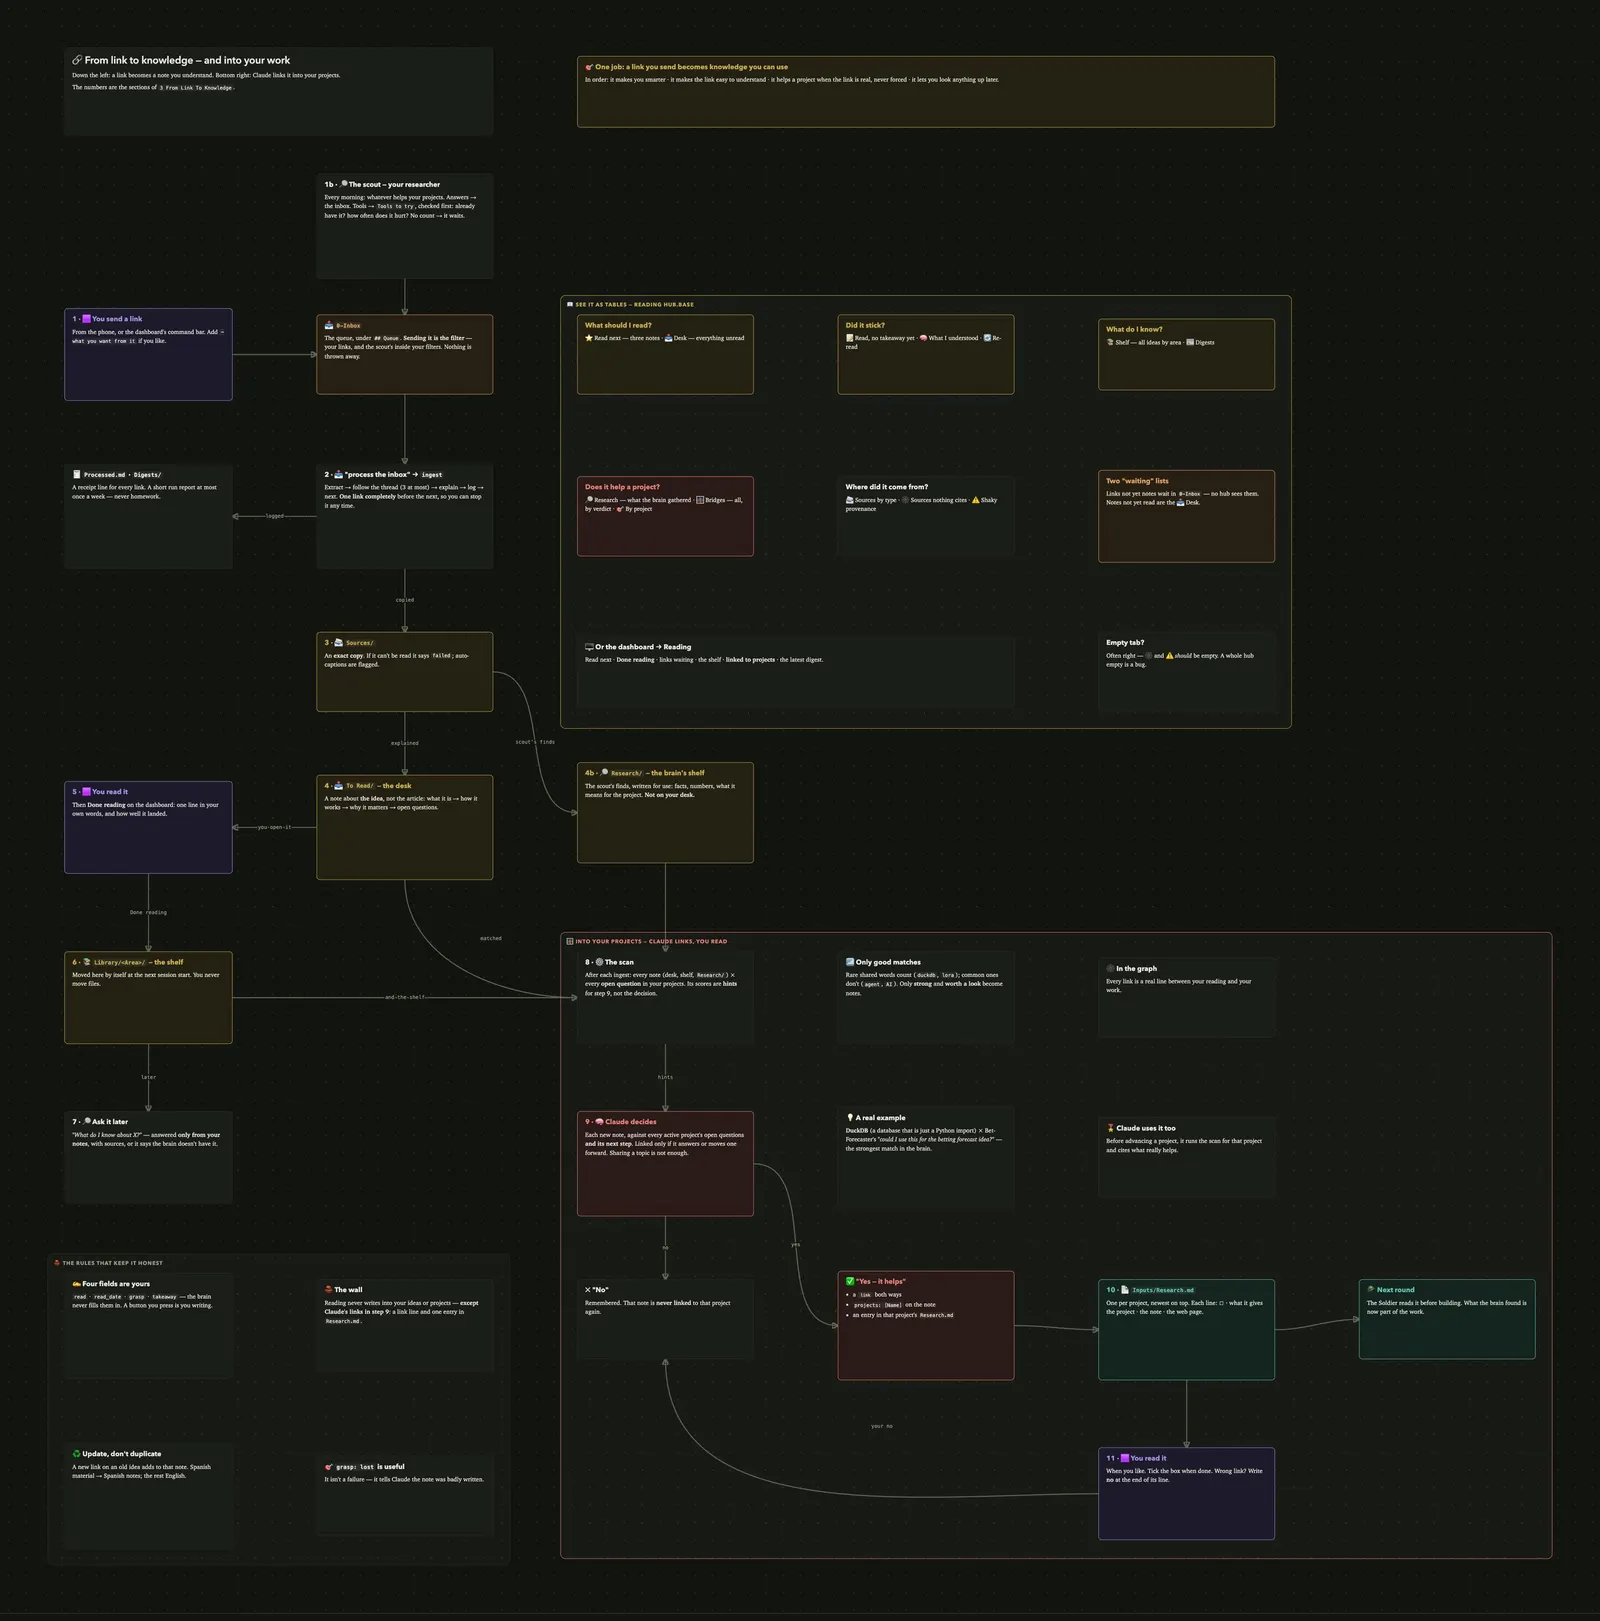
Figura: del enlace al conocimiento, y de ahí al proyecto. Copia exacta del canvas de Obsidian.
Fuerza del puente, con un ejemplo
Una nota sobre DuckDB obtuvo 0,469 frente al proyecto de predicción porque respondía a una de sus preguntas abiertas: dónde almacenar los datos numéricos. Hoy DuckDB es la base de datos de ese proyecto.
El investigador y el periódico
Cada mañana un investigador programado busca herramientas, técnicas, datos y respuestas que ayuden a cada proyecto, guiado por una línea por proyecto. Las herramientas que encuentra solo se listan, nunca se instalan, y cada una tiene que pasar dos filtros: superar lo que ya tengo y eliminar un problema que pueda contar en mis propios registros. Cada noche otra tarea programada escribe un periódico de fondo blanco sobre economía, empresa y política, con una línea que enlaza cada noticia con mis temas de examen, palabras de glosario, un botón «explícalo sencillo» y preguntas que el sistema responde desde las fuentes.
Content Engine
Agosto 2026 – actualidad
Arquitecto
Una plataforma de producción de contenido generado con IA con su propio panel: de una petición a una pieza publicable, con cada paso visible, aprobable y reproducible.
Python
Image, video and voice model APIs
ffmpeg
Custom node editor
Custom web dashboard
Headless Claude
6 pipelines
6 AI characters
Contexto
Producir contenido generado a escala exige tres cosas a la vez: personajes que no cambian de cara ni de cuerpo, imágenes y vídeo que parezcan grabados por una persona real y un control estricto del gasto y de la calidad. Un generador de imágenes suelto no ofrece ninguna de las tres.
Solución
Un motor con adaptadores a modelos de imagen, vídeo y voz, montaje determinista y registro de cada llamada, y un panel propio. Cada tarea es una ejecución con su historial y su tubería se abre como un editor de nodos. Las ejecuciones que cuestan dinero se preparan y se detienen hasta que las apruebo con el precio exacto a la vista.
Resultados
173 carruseles en 11 formatos producidos para publicidad (banco contado el 3 de noviembre de 2026)
6 personajes de IA consistentes creados con la misma secuencia
6 tuberías de producción, cada una con su editor completo
44 ejecuciones registradas con sus imágenes, ajustes y pasos
Los pasos de pago no se pueden ejecutar sin mi aprobación
Se usa para contenido de TikTok Shop y anuncios realistas para marcas
En cifras
Unas 113.000 líneas de Python: el motor (60.300 líneas en 78 archivos, 17.500 de ellas pruebas), las tuberías (28.100 líneas), las herramientas (9.300 líneas) y el servidor del panel (15.500 líneas) con una aplicación de una sola página de 10.666 líneas.
76 modelos integrados con tres proveedores: imágenes, ediciones, ampliadores, voz, sincronización labial, avatares, efectos de sonido y 26 modelos de vídeo.
133 rutas de panel, 7 vistas y 6 tuberías que se abren cada una como un editor completo, con 28 estilos de imagen en el pack promocional y 4 formatos de vídeo.
1.325 llamadas a modelos registradas en el libro de cuentas entre el 1 de septiembre y el 3 de noviembre en 48 modelos, cada una con su hora, modelo, finalidad y la pieza a la que pertenecía.
9 personajes de IA creados, 3 actuales y 6 archivados, cada uno una receta repetible en un archivo de personaje.
173 carruseles con 921 diapositivas en 11 formatos, 8 de ellos dibujados por código en un solo día (9 de octubre) con una prueba de 37 comprobaciones superada, incluida una que demuestra que el kit de plantillas de la propia empresa nunca se modificó.
Una corrección medida de la deriva de identidad: con 5 imágenes de referencia un lote conservó 12 de 19 (63 %); con las mismas fotos fallidas, 3 imágenes de referencia conservaron 5 de 5 (muestra pequeña, de 5). El listón de un lote es el 90 %.
Una comparación de 27 imágenes en 9 modelos y 3 escenas (piel, cuerpo entero, selfie en espejo), con 27 de 30 ejecuciones correctas, y un comprobador de caras con Apple Vision que avisa de una foto de origen difícil antes de crear la imagen.
El trabajo que hice con él
En septiembre y octubre de 2026 usé el motor para una empresa que pagaba a creadores por publicar carruseles publicitarios en redes sociales de vídeo corto. Construí un sistema para generar personajes de IA consistentes, cuya cara y cuerpo no cambian de una imagen a otra, y lo estandaricé para producir carruseles en masa para publicidad. En qué consistió la estandarización:
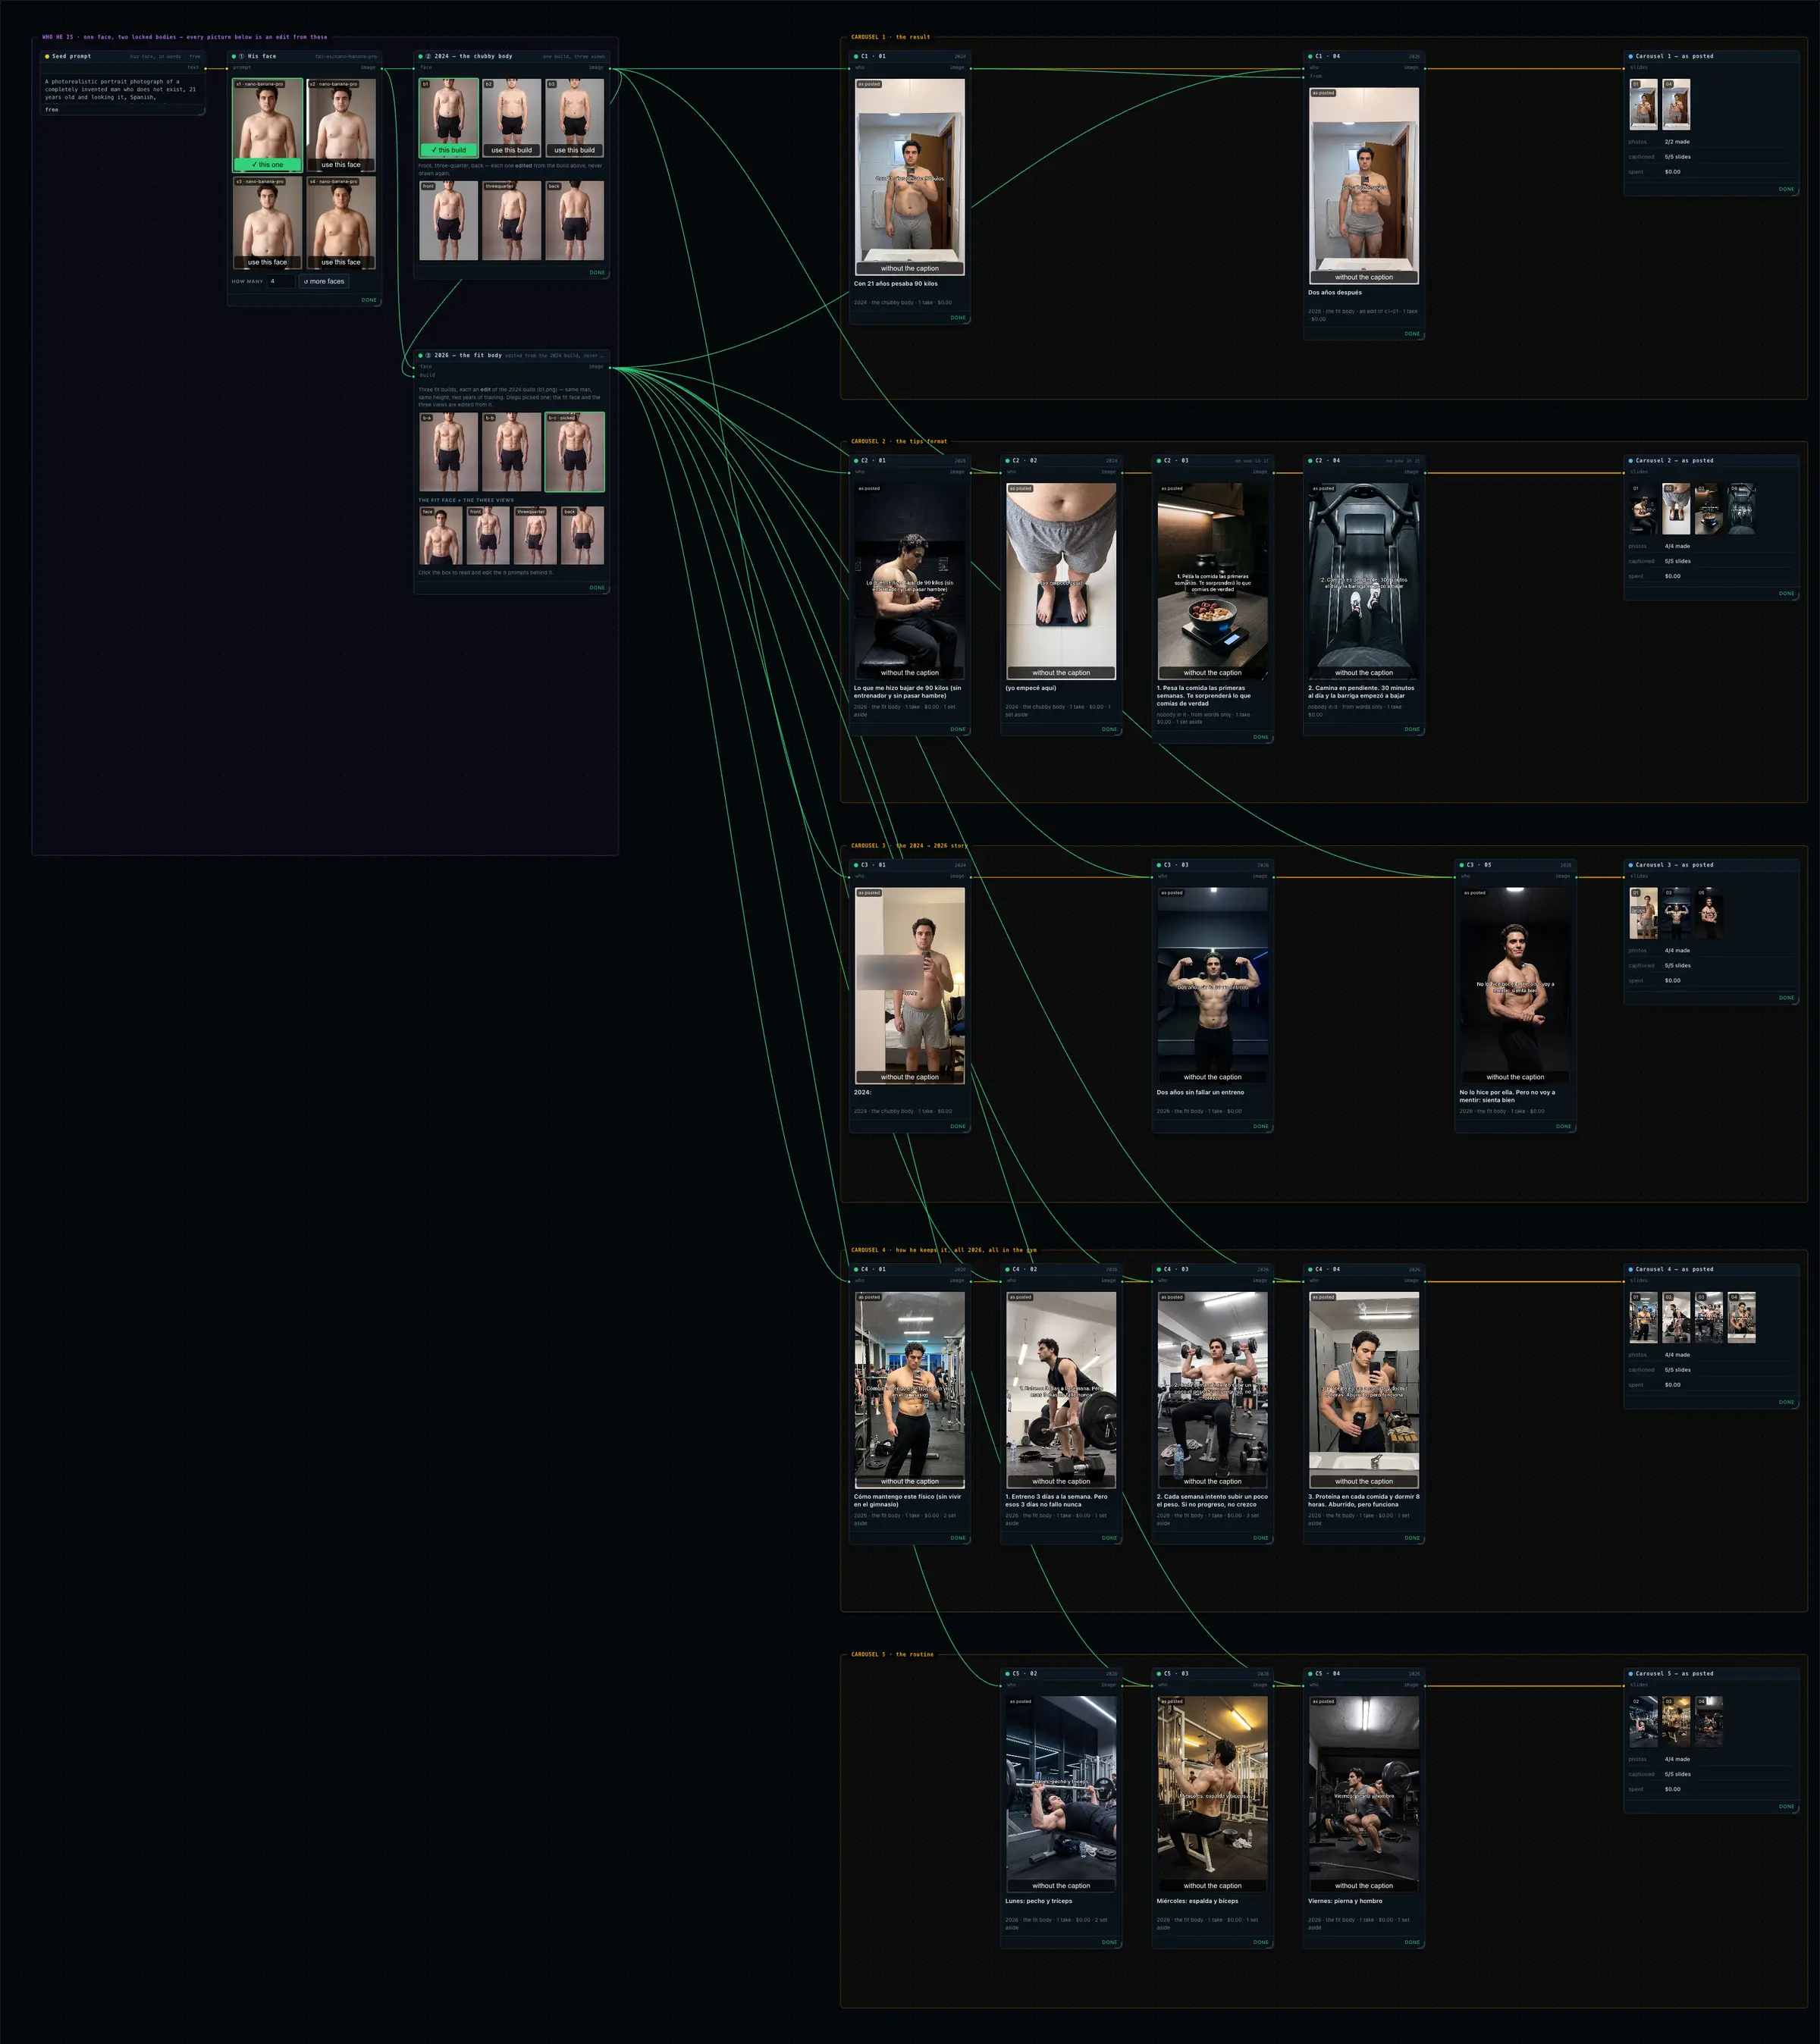
Personajes: seis personajes de IA, cada uno creado con la misma secuencia (una persona descrita, caras propuestas, una elegida, todos los ángulos y cuerpos derivados de esa cara). Cada imagen nueva es después una edición de una foto de referencia real, de modo que el encuadre y la luz parecen de algo grabado por una persona.
Formatos: cada formato de carrusel pasó a ser una plantilla fija, 11 en total, y 8 de ellos se dibujaron con los renderizadores del kit de creadores de la propia empresa para que el resultado coincidiera con lo que ella publicaba.
Flujo semanal: un plan de líneas de producción por semana (93 líneas en el segundo plan semanal) convertido en carruseles por un único flujo, con un banco organizado por formato donde cada carrusel se guarda una vez y solo se reutiliza bajo reglas escritas.
Controles: un informe diario breve, un script que comprueba que una iteración solo cambia un par de palabras y una regla por la que el tablero de un personaje muestra todo lo que tiene, aplicada con un hook que detiene el trabajo si no se cumple.
Resultado: 173 carruseles en 11 formatos en el banco, contados el 3 de noviembre de 2026.
Los dos flujos tal como los usé
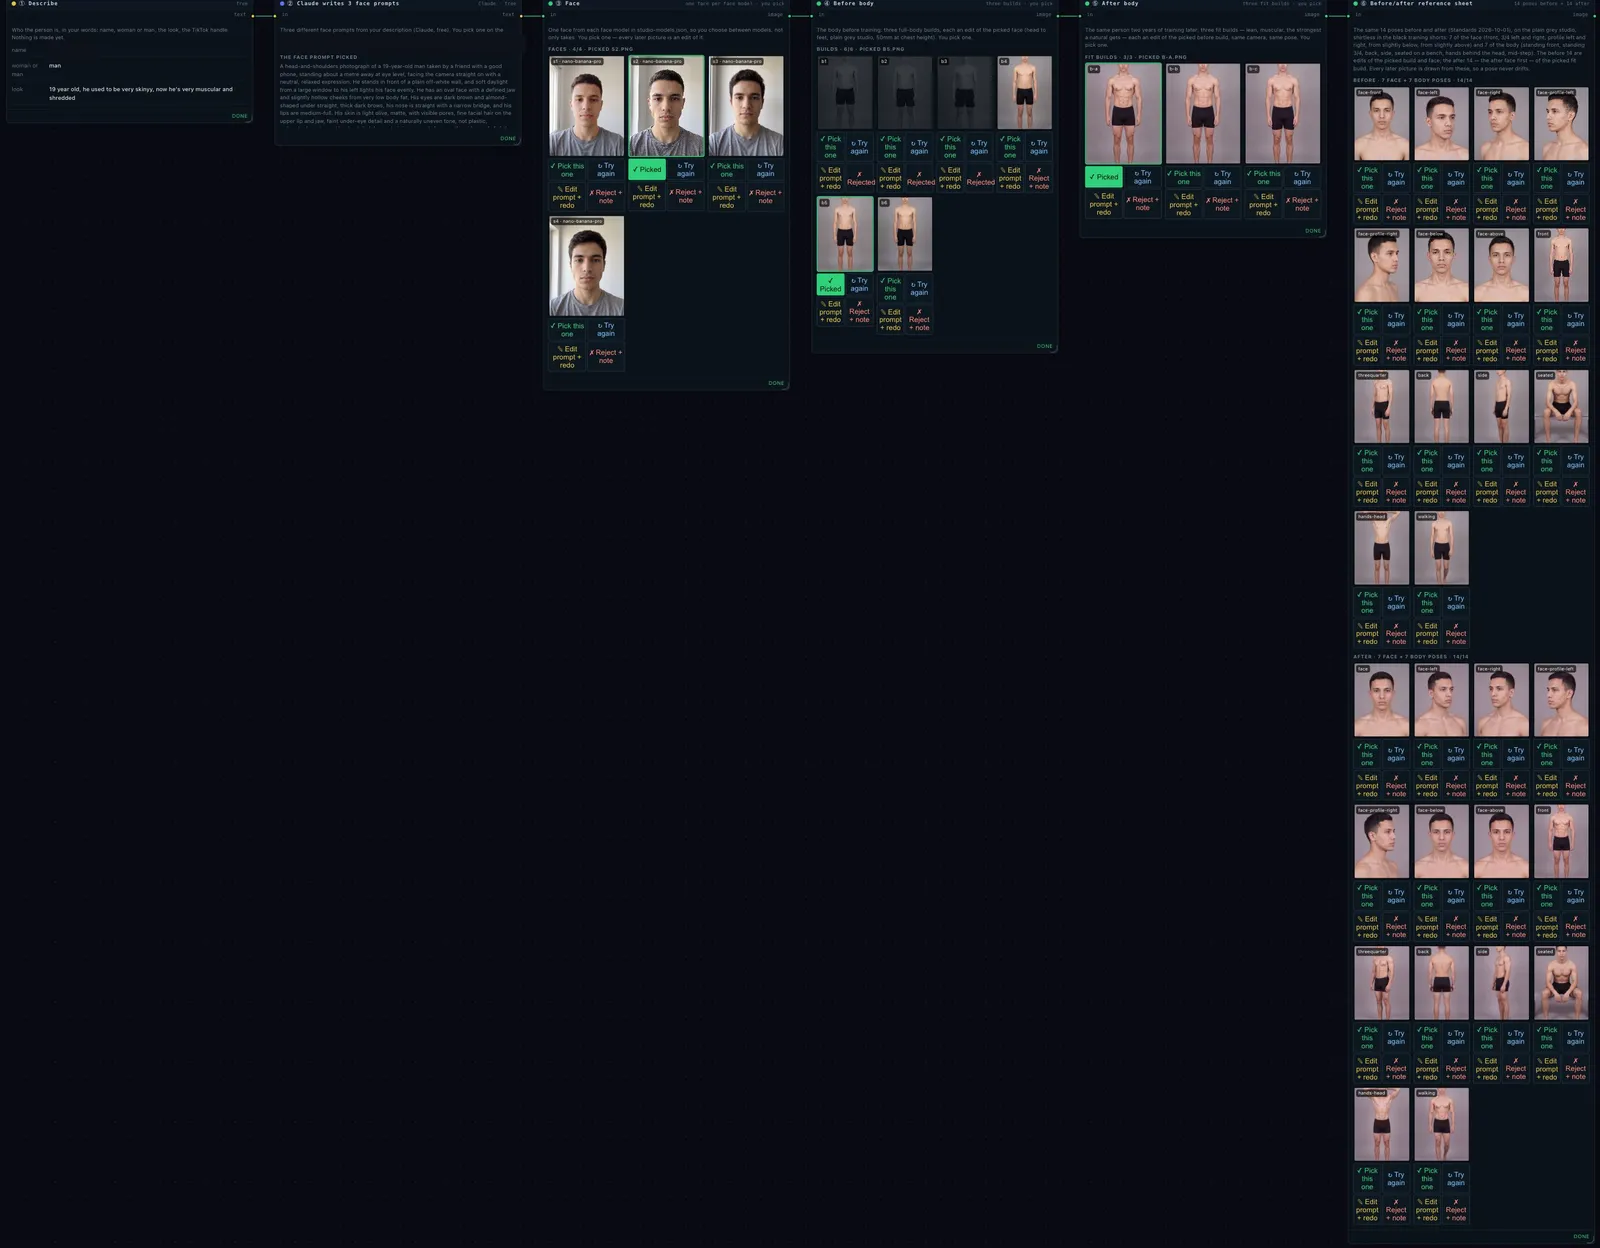
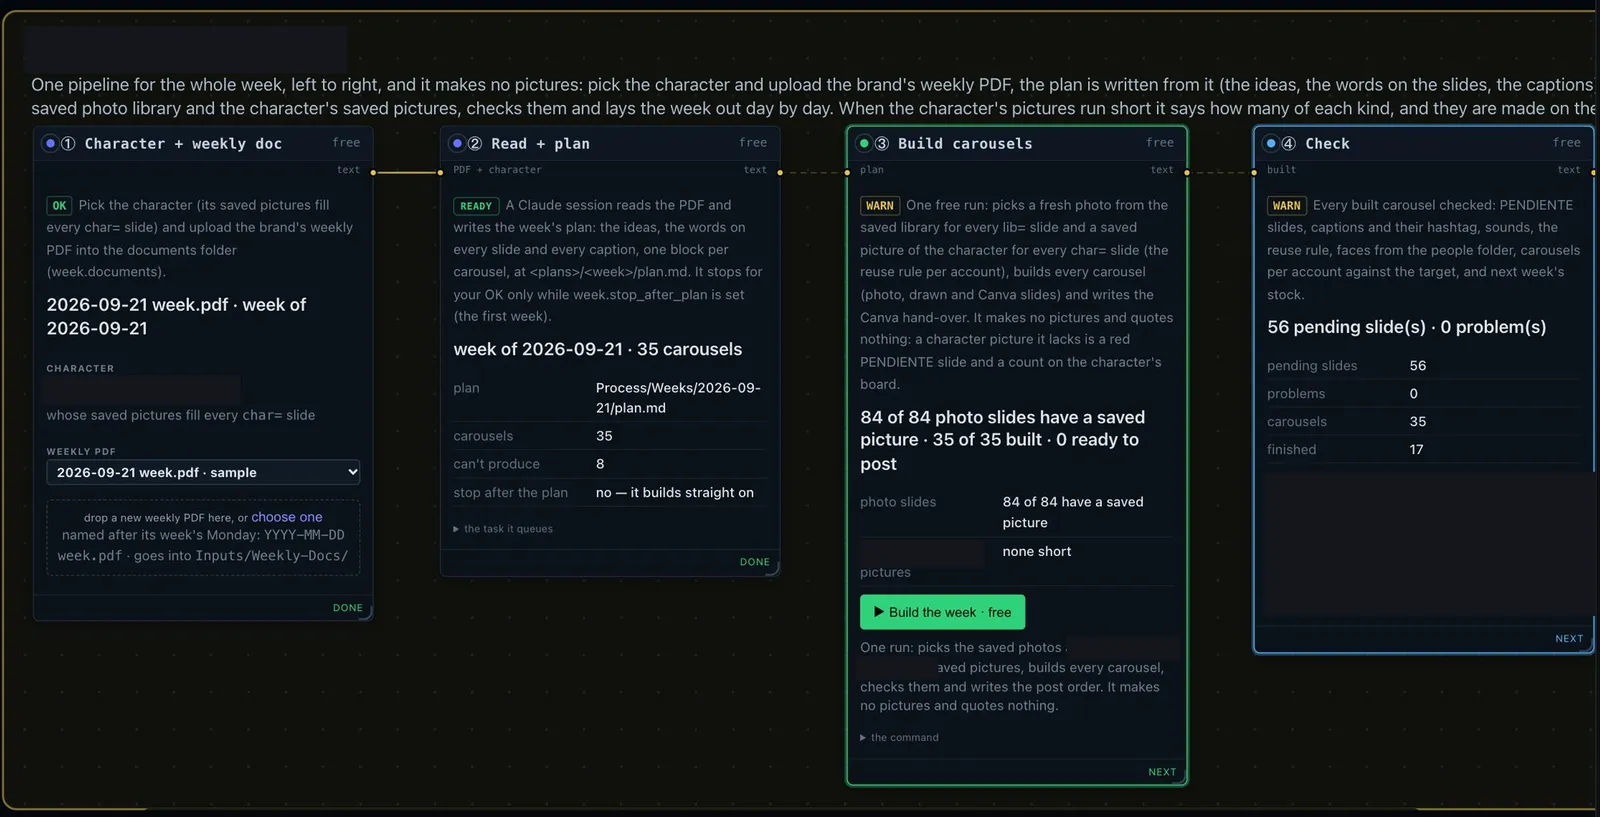
Figura: el flujo de personaje que usé para el trabajo publicitario, tal como lo mostraba el editor de tuberías: una descripción, tres prompts de cara escritos por Claude, cuatro caras generadas con una elegida, seis cuerpos «antes» y tres cuerpos «después», y una hoja de referencia 14 + 14 con todos los ángulos antes y después. Cada imagen se puede elegir, rehacer, editar o rechazar con una nota. Se ha tapado el nombre del personaje.Figura: la tubería semanal de carruseles. Entran el personaje y el documento semanal de la empresa; una sesión de Claude lee el documento y escribe el plan de la semana; una ejecución construye todos los carruseles con fotos guardadas y las imágenes del personaje; una comprobación final lista lo pendiente. Esta semana: 35 carruseles, 84 de 84 diapositivas de foto con imagen guardada. Se han tapado los nombres.Figura: el tablero del primer personaje, tal como lo mostraba el editor. A la izquierda, su generación: un prompt inicial, cuatro caras con una elegida, tres cuerpos y tres cuerpos en forma con sus vistas. A la derecha, cinco carruseles terminados, cada diapositiva una edición de esas bases, con su texto y su recuento de imágenes hechas. Se han ocultado las diapositivas que nombran a la empresa y los nombres de cuenta, por eso algunas filas muestran menos diapositivas.
Todo ello forma ahora parte del motor: los personajes, los formatos, el flujo semanal y los controles.
El plan
El motor sirve ahora a dos direcciones. Primera, modelos de IA para empresas: personajes de IA consistentes usados como modelos propios de una marca en su publicidad, producidos con el mismo flujo estandarizado. Segunda, contenido de TikTok Shop: packs promocionales con el producto fijado, y vídeos, hechos y publicados por una persona a la que formo. El siguiente paso técnico es el vídeo: elegí un modelo de vídeo a ojo entre una muestra de candidatos lado a lado, y el siguiente paso es una prueba corta para ver si acepta la cara del personaje, habla un español natural de España y parece grabado, antes de producir en volumen. Las tuberías de packs y de vídeo están construidas y probadas, y nada de pago se ejecuta sin mi aprobación.
El panel de control
Ejecuciones
Cada tarea es una tarjeta con su tubería, sus imágenes y vídeos, sus ajustes y sus pasos. Se puede repetir una ejecución, abrir su carpeta o descargarla entera. Las que esperan aprobación van primero.
Editor de tuberías
Cada paso es un nodo con su configuración, su modelo y su botón de ejecución. Sobre cada imagen puedo elegirla, rehacerla, editar el prompt y rehacer, o rechazarla con una nota.
Bucle de realismo
Cada ✓ o ✗ con su nota se guarda, con fecha, en las normas del proyecto, y todos los prompts que el motor escribe después las leen. El sistema aprende de cada corrección.
Instrucciones
Una caja de texto que lanza a Claude en segundo plano. Muestra su lista de tareas avanzando, deja una nota de lo hecho y se puede deshacer. No puede gastar: un paso de pago solo se ejecuta con mi aprobación.
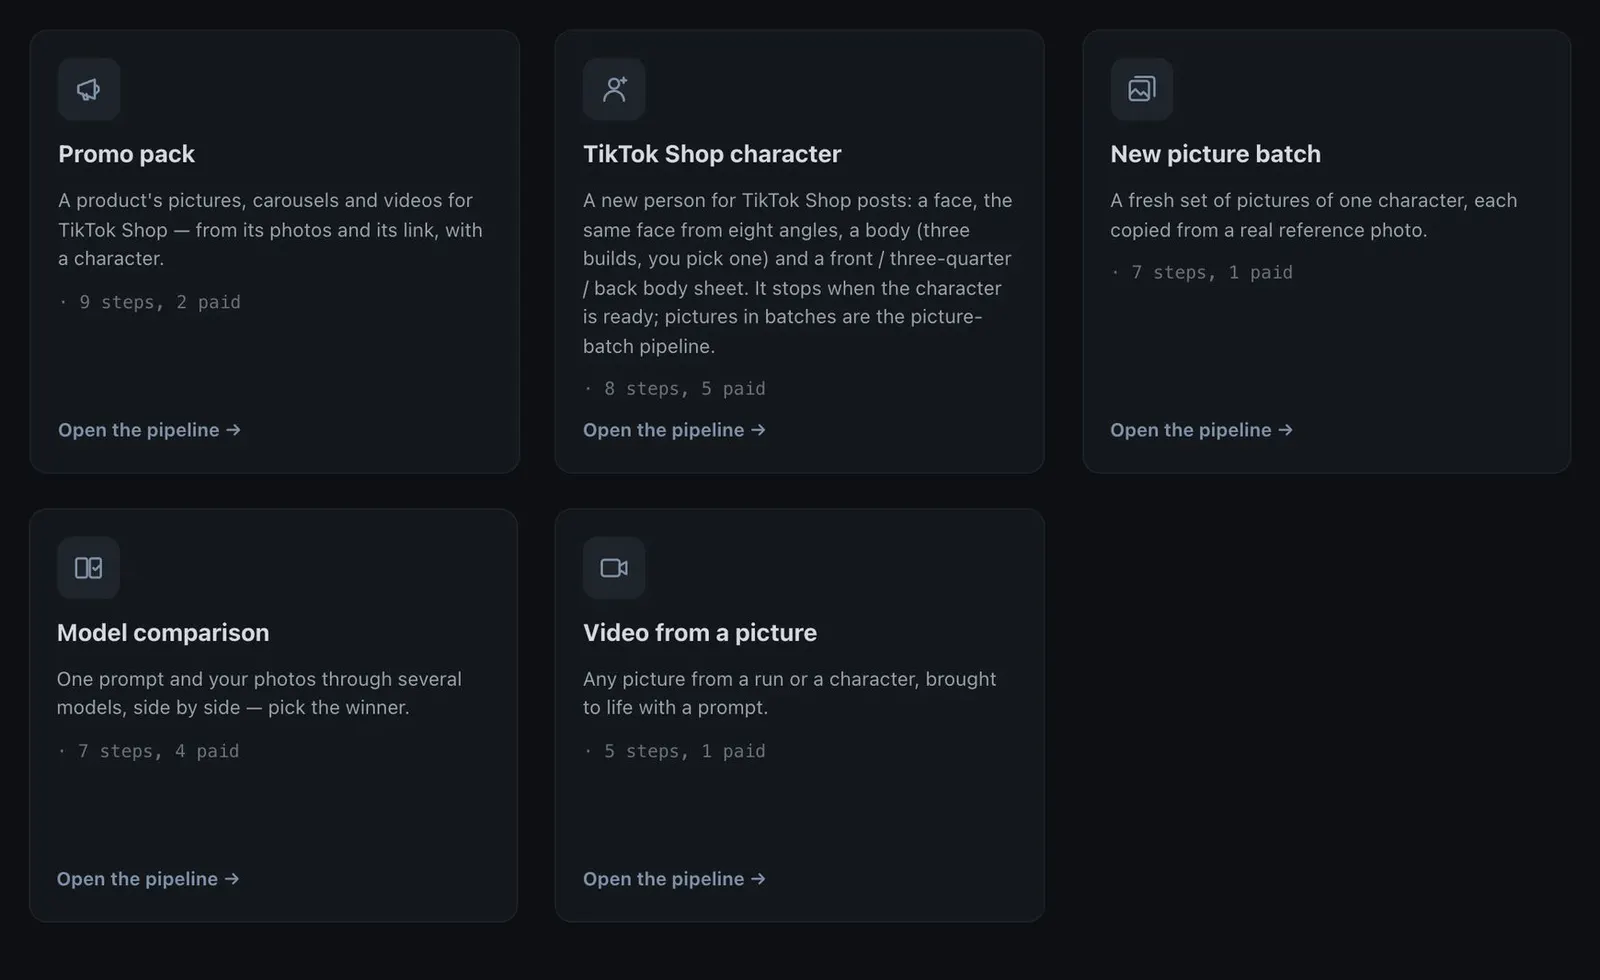
Figura: el catálogo de tuberías. Cada una se abre como un editor completo.
Tuberías de producción
Vídeo de TikTok Shop (12 pasos)
Producto, personaje, formato y mercado, vídeo de referencia, guion con tres ganchos, primeros fotogramas generados a partir de fotos reales, voz, clips, sincronización labial, montaje, comprobación y vídeo final.
Personaje (8 pasos)
Descripción, tres propuestas de cara, ocho ángulos de la cara elegida, tres construcciones corporales entre las que elijo, hojas de cuerpo de frente, tres cuartos y espalda, y entrenamiento opcional.
Promo pack (9 pasos)
A partir de las fotos de un producto, un personaje y un enlace, genera publicaciones, carruseles y vídeos con el producto fijado para que no cambie de una imagen a otra.
Lote imagen a imagen
Cada imagen del banco de un personaje parte de una foto real y solo cambia la identidad, de modo que el encuadre y la luz son los de una foto real. Un control mide qué porcentaje de cada lote conserva la identidad y exige un 90 %.
Comparación de modelos y vídeo desde una imagen
Dos tuberías más pequeñas para probar modelos de imagen y vídeo en paralelo antes de decidirse por uno.
Un flujo en el editor
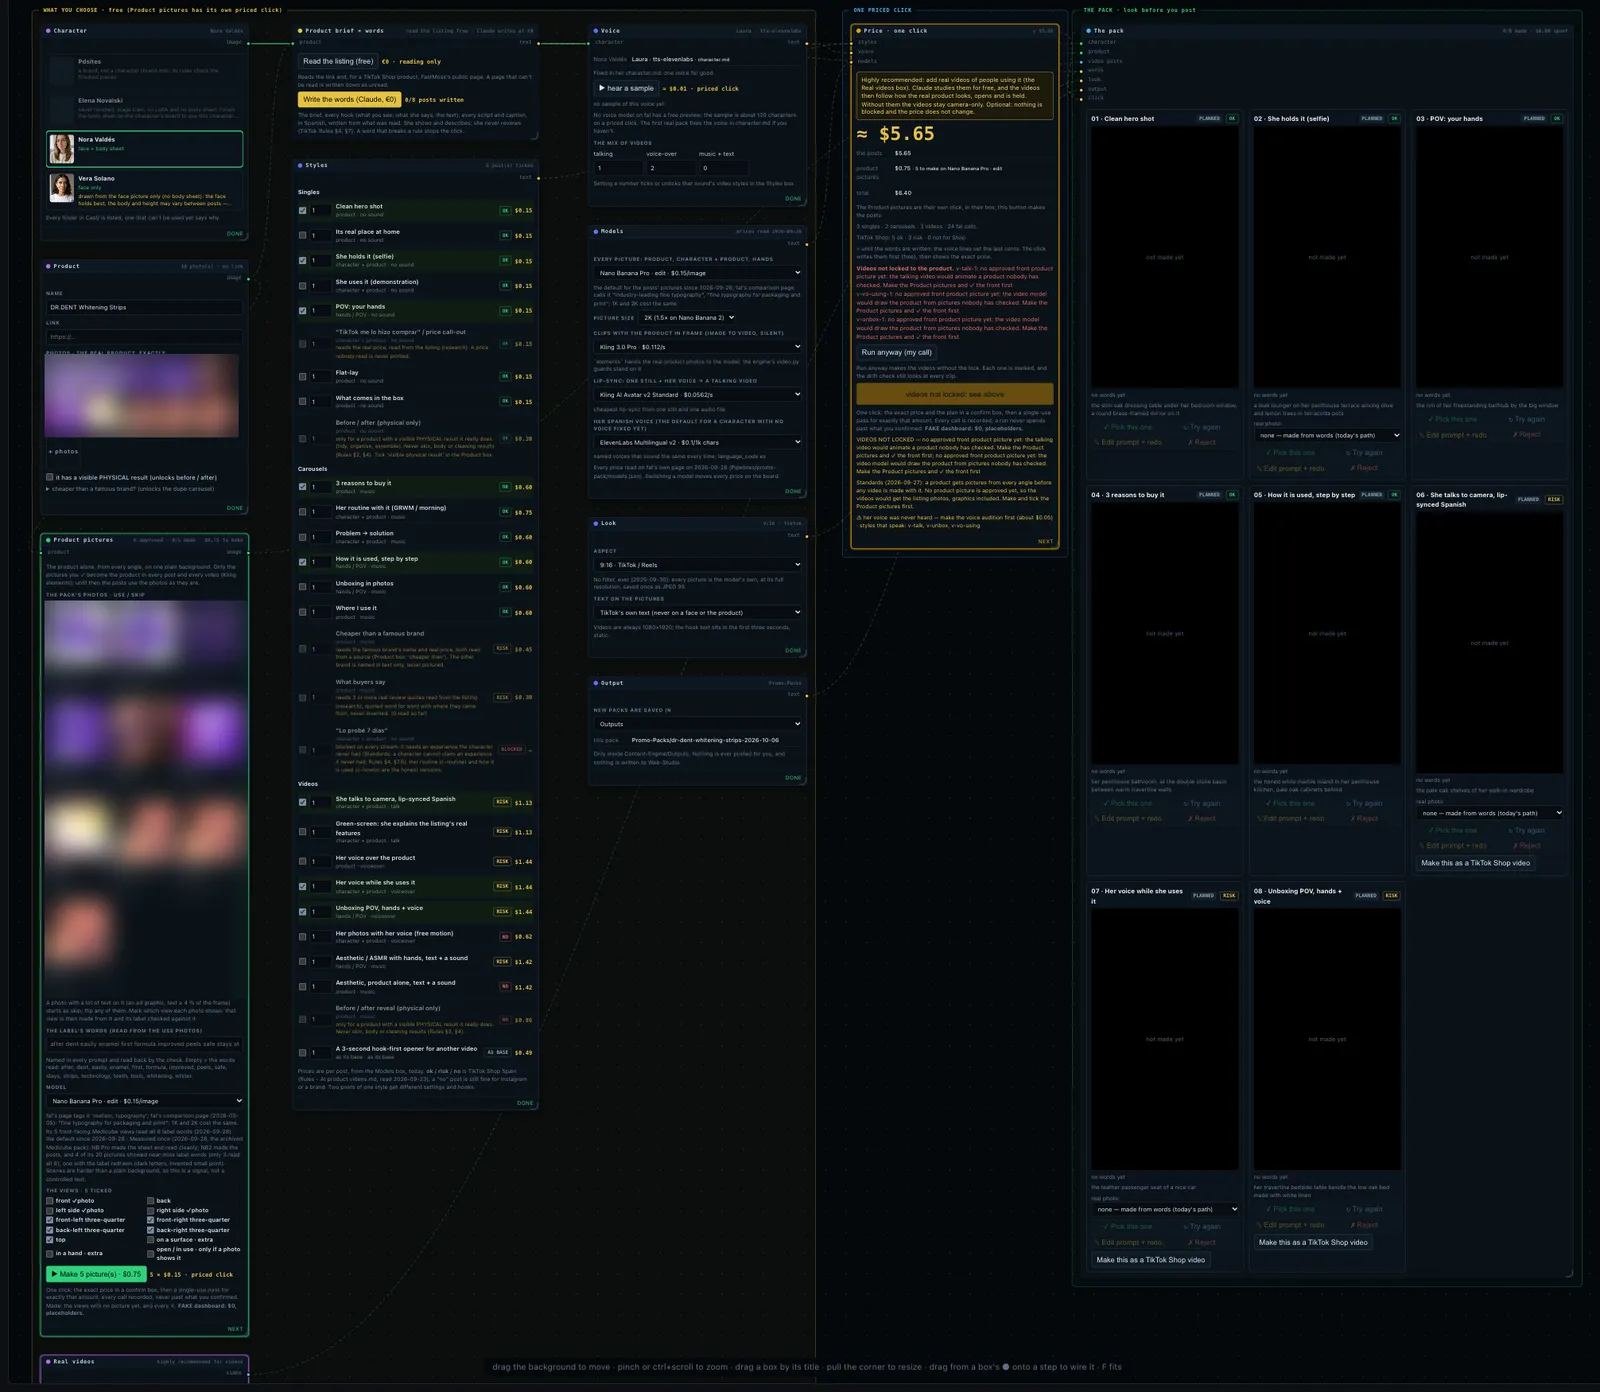
Figura: un flujo de pack promocional tal como lo muestra el editor de tuberías: el personaje, el producto con sus fotos, el guion y los estilos de publicación elegidos, la voz, los modelos, el aspecto, la carpeta de salida, un único clic con precio y el pack de publicaciones por revisar. Los precios son las estimaciones del motor, mostradas antes de aprobar cualquier paso de pago. Las fotos del producto están difuminadas.
Bet-Forecaster
Julio – septiembre 2026 · con un socio
Cocreador
Motor construido · en pausa hasta demostrar su valor
Una plataforma de predicción de fútbol que combina datos históricos, cuotas en vivo y modelos estadísticos para buscar errores de precio de las casas de apuestas. Nunca realiza apuestas.
Python
DuckDB
Football data APIs
Live odds API
Claude Code
27 tools
175 tests
Contexto
Las casas de apuestas fijan sus precios con equipos de analistas. Encontrar una ventaja real exige más datos, un modelo reproducible y un método que no se engañe con aciertos por azar.
Solución
Una plataforma conectada a fuentes de datos de fútbol y a una API de cuotas en vivo, con una base analítica en DuckDB, un modelo de Poisson de goles calibrado y un escáner que revisa los próximos partidos y señala los precios por encima de su valor justo. El modelo de lenguaje orquesta y explica; todos los cálculos son deterministas.
Resultados
94.511 partidos de 25 divisiones, 2012–2026
Una regla probada en seis temporadas no vistas superó la cuota de cierre en el 82,7 % de sus selecciones
27 herramientas y 175 pruebas superadas
Un panel de seis vistas con escaneo bajo demanda
En cifras
94.511 partidos en 25 divisiones (22 europeas más Argentina, EE. UU. y Brasil) a lo largo de 27 temporadas y 676 clubes, con cuotas de cierre en 93.199 y datos de goles esperados en 19.649.
31 herramientas de Python en 9.802 líneas con una única dependencia fijada, y 12 herramientas con autopruebas sin conexión: 208 comprobaciones pasan con 0 fallos.
13 hipótesis, cada una con su condición de descarte escrita antes de ningún resultado, y archivos de preinscripción guardados antes de ejecutar el código en las rondas 4 a 7.
Resultados negativos honestos, dichos sin rodeos: un modelo de Poisson perdió contra la cuota de cierre en 1.900 partidos de La Liga nunca ajustados (log-loss 0,995 frente a 0,968), y con una capa de calibración el mercado siguió ganando la predicción del resultado en las 22 divisiones.
Una idea con ventaja medida, contada con sus reservas: en una ventana congelada antes de la selección tuvo 234 apuestas, un valor sobre la cuota de cierre de +6,64 % y t = 2,17, positivo en las 4 temporadas, pero no sobrevive a la corrección por 22 pruebas simultáneas.
Detalles técnicos
Datos
Resultados, estadísticas y cuotas de apertura y cierre de varias casas desde 2012; cuotas en vivo capturadas por API con presupuesto de llamadas; noticias fechadas por partido. Cada fila guarda su fuente y fecha de ingesta, y la base completa se reconstruye con un solo script.
DuckDB
54 columnas por partido, 676 equipos, consultas en unos 12 ms sin servidor. Regla de diseño: los números van a la base de datos y el texto a la búsqueda.
Modelado
Tres métodos para eliminar el margen de la cuota de referencia, un modelo de Poisson de goles con capa de calibración, intervalos por bootstrap de 400 remuestreos y combinadas del mismo partido calculadas desde la matriz conjunta de marcadores.
Método
Cuatro rondas de backtest con hipótesis registradas antes de probarlas, validación fuera de muestra y seguimiento frente a la cuota de cierre, la métrica que usan los profesionales en lugar del porcentaje de aciertos. Tres rondas fueron negativos honestos; la hipótesis que sobrevivió solo funcionó en mercados poco líquidos.
Riesgo
Probabilidad mínima del 60 %, un «no apostar» explícito cuando nada la supera y ninguna ejecución automática de apuestas.
Figura: los dos enfoques evaluados: detectar errores de la casa frente a predecir por cuenta propia. Copia exacta del canvas del proyecto.Figura: el reparto de funciones entre el modelo de lenguaje, DuckDB y la búsqueda. Copia exacta del canvas del proyecto.
Otros trabajos con IA
Webs y registro horario para un comercio local
Una web bilingüe para un supermercado de productos europeos y el registro horario de empleados que exige la ley española. Ambos están construidos y todavía no están en producción; los datos de los empleados están protegidos por un bloqueo que ningún agente puede atravesar.
IA para una inmobiliaria familiar
Investigación sobre dónde puede ayudar la IA a una inmobiliaria familiar a conseguir más captaciones y vender más: captación de contactos, textos de anuncios y lógica de campañas. En marcha; nada está en producción todavía.
Herramientas de repaso para mis propios exámenes
Apuntes, diagramas y preguntas de repaso escritos con Claude a partir de las especificaciones oficiales, y un libro de repaso interactivo. Las notas se comprueban a ciegas contra los esquemas de corrección oficiales.
Trabajo de diseño digital
La identidad de una marca ficticia de moda masculina para una asignatura de comunicación gráfica. Los diseños finales se hacen en programas de Adobe a través de un conector de IA, cada paso queda registrado y cada imagen generada con IA se acredita con su prompt exacto.
Sistemas de segundo cerebro para otros
Un manual de entrega para construir sistemas de segundo cerebro a medida sobre el patrón de mi propio entorno. Diseñado; todavía sin clientes.
Formación y resultados
Economics, Pearson Edexcel International A-level, AS (junio de 2026)
195/200, nota A.
Business, Pearson Edexcel International A-level, AS (junio de 2026)
157/200, nota B.
Español, Pearson Edexcel International A-level (junio de 2026)
366/400, nota A.
IGCSE (junio de 2025)
Pearson: English Language 8 · Business 7 · Mathematics 7 · English Literature 6. Cambridge: Literature in Spanish B.
Resumen
En los últimos meses he pasado de usar la IA a diseñar sistemas que trabajan con ella de forma fiable: un estudio que entrega webs y automatizaciones a clientes reales, un entorno de trabajo que planifica, ejecuta y se revisa solo, y productos propios con datos, estadística y agentes.
Lo que aporto a un equipo es la combinación de tres cosas: entender un problema y convertirlo en un plan con criterios de éxito claros, construir el sistema que lo resuelve y asegurarme, con pruebas y no con impresiones, de que funciona y sigue funcionando. Doy mis números con su tamaño de muestra, también los que no llegan al objetivo.
Estaré encantado de enseñar cualquiera de estos sistemas en directo.